
A Alibaba lançou o Qwen4-Max, o modelo mais capaz da família Qwen até agora. É um modelo de mistura de especialistas (MoE) com 2,4 trilhões de parâmetros no total, visão nativa e janela de contexto de 1 milhão de tokens. O anúncio é de 16 de novembro de 2026, em Hangzhou, depois de uma prévia limitada que começou em 11 de novembro. O modelo já está disponível na API do QwenCloud, e os pesos não foram abertos.
O que é o Qwen4-Max
A Alibaba descreve o Qwen4-Max como um “novo colega de equipe de IA” para trabalho, criatividade e descoberta. A empresa destaca desempenho em programação, tarefas de agentes e raciocínio visual. A arquitetura Qwen4 atualiza o desenho MoE esparso em atenção, conexões residuais e embeddings. Por token, o modelo ativa 71 bilhões de parâmetros, 25% menos que o Qwen3.8-Max, que tem a mesma escala total de 2,4 trilhões. A ideia é entregar mais capacidade com custo de inferência menor.
Onde usar e quanto custa
- Desenvolvedores: API do QwenCloud e Token Plan.
- Produtos da Alibaba: QwenWork e Qwen Studio, além do Qoder, segundo a cobertura da imprensa.
- Preço: a Alibaba informa US$ 0,075 por milhão de tokens de entrada com acerto de cache implícito. O preço de tabela, de US$ 1,50 por milhão de tokens de entrada e US$ 4,50 por milhão de saída, vem da cobertura do The Next Web, e não do comunicado da empresa.
- Pesos: o Qwen4-Max não é aberto. A Alibaba diz que modelos menores da série Qwen4 terão pesos abertos em breve, sem data.
O que os testes mostram
A Alibaba diz que o Qwen4-Max está entre os primeiros em testes de programação, agentes, produtividade no trabalho e raciocínio visual. O comunicado cita o 6º lugar no Code Arena, um ranking de programação em cenários reais, e bons resultados em Agents’ Last Exam, Vals Index, JobBench e Chartography. Os números são divulgados pela própria empresa.
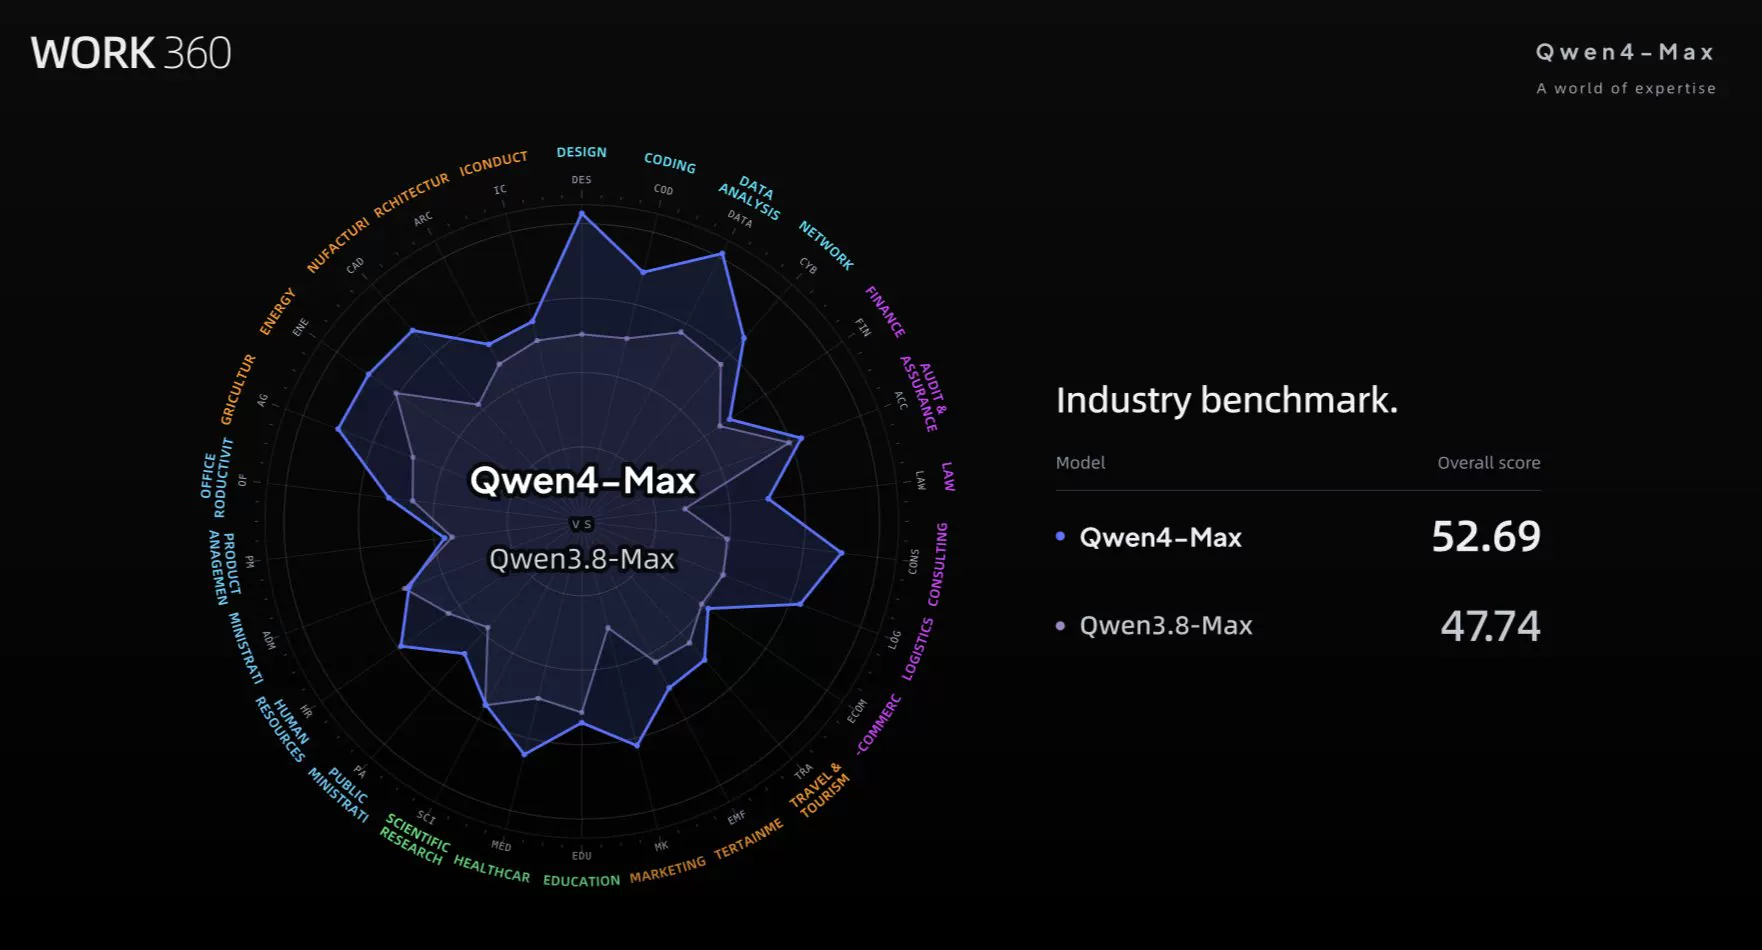
No Work360, um teste proprietário da Alibaba com tarefas de 721 áreas especializadas, o Qwen4-Max marcou 52,69, contra 47,74 do Qwen3.8-Max. Com o raciocínio no nível alto, o modelo usa 35% menos tokens e reduz o custo médio por tarefa em cerca de 60%. Os veículos divergem no valor exato: o The Next Web fala em queda de US$ 4,43 para US$ 1,67, e o TechNode em RMB 26,58 para RMB 11,16, cerca de 58%.
Sobre a comparação com modelos americanos, o The Next Web relata, citando a análise do FourWeekMBA sobre os gráficos da Alibaba, que o Qwen4-Max fez 75,7 no DeepSWE v1.1, à frente do Claude Opus 5.5, com 74,2. No Terminal-Bench 4.0, porém, o resultado foi 48,5, atrás do Claude Opus 5.5 (59,6) e do Kimi K3.1 (67,2). Esses números não estão no comunicado oficial e não foram verificados de forma independente.
Casos de uso citados pela Alibaba
- Recursos de nuvem: o modelo otimiza os próprios fluxos de agendamento em ciclo fechado. Nos testes, reduziu em média 9% o custo de chamadas de modelos de anotação de dados e acelerou em mais de 14 vezes o reagendamento de CPU offline.
- Criação: modelagem 3D, desenvolvimento de jogos e criação de vídeo com agentes.
- Manufatura automotiva: numa demonstração, o tempo de programação manual de peças caiu 95%, de cerca de 475 para 24 minutos, com iteração guiada por feedback para detectar cortes excessivos e remoção insuficiente de material antes da usinagem.
- Ciência: uma execução contínua de 48 horas de um agente, em quatro iterações, descobriu uma molécula de refrigerante para o resfriamento de chips, validada em experimento. Em um teste sobre Alzheimer, o modelo executou 454 chamadas de ferramentas e 3.239 avaliações de métricas para projetar e otimizar 24 moléculas candidatas.
- Agentes: a Alibaba também lançou um plugin para que agentes entreguem uma primeira versão do trabalho e revisem conforme o feedback, segundo o TechNode.
Segurança
O treinamento de engenharia de software incluiu verificações de segurança de código além dos testes de funcionalidade, para reduzir falhas como injeção, segurança de memória e controle de acesso quebrado. Em cibersegurança, a Alibaba filtrou os dados de treinamento pela intenção da tarefa, mantendo material defensivo e removendo conteúdo de ataque. Há também conjuntos de dados de segurança e ajustes de pós-treinamento para riscos químicos, biológicos, radiológicos e nucleares. Esses são relatos da empresa, sem avaliação externa.
O que a Alibaba não informa
- Brasil: não há menção a disponibilidade, idioma ou preços locais.
- Pesos abertos: só os modelos menores terão, e não há data.
- Comparação detalhada: o comunicado não traz tabela completa com Claude, GPT e Gemini. Os números contra o Opus 5.5 vêm de análises de terceiros sobre os gráficos da empresa.
- Preço de tabela: o comunicado cita apenas o preço com cache.
Minha leitura
O Qwen4-Max chega com uma proposta clara: manter o nível de um modelo de fronteira gastando menos tokens e menos por tarefa. O contexto de 1 milhão de tokens, a visão nativa e o preço de entrada de US$ 1,50 colocam o modelo na mesma faixa de preço do Gemini 4 Hydrogen, lançado na semana passada. Os testes divulgados mostram um quadro misto: vantagem no DeepSWE, mas atraso no Terminal-Bench 4.0 contra o Opus 5.5. Como os números são da própria Alibaba e há divergência entre veículos sobre a redução de custo, o caminho prudente é testar nas suas tarefas.
Para quem é e para quem não é
É para desenvolvedores e empresas que montam agentes de longa duração, fluxos de código e trabalho de conhecimento e querem reduzir custo por tarefa, e para quem precisa de contexto longo e visão em um só modelo. Não é a melhor aposta, por ora, para quem exige pesos abertos para rodar localmente, já que o Max é fechado, nem para quem depende de resultados de terminal, onde a comparação divulgada mostra o Claude Opus 5.5 à frente. Quem está no Brasil deve confirmar acesso e cobrança no QwenCloud.
Perguntas frequentes
O que é o Qwen4-Max?
O modelo mais capaz da família Qwen, da Alibaba: MoE com 2,4 trilhões de parâmetros, 71 bilhões ativos por token, visão nativa e 1 milhão de tokens de contexto.
Ele é de código aberto?
Não. Os pesos do Qwen4-Max não foram abertos. A Alibaba diz que modelos menores da série Qwen4 terão pesos abertos em breve.
Quanto custa?
Segundo o The Next Web, US$ 1,50 por milhão de tokens de entrada e US$ 4,50 por milhão de saída. A Alibaba informa US$ 0,075 por milhão de tokens de entrada com acerto de cache.
Onde posso usar?
No QwenCloud, por API e Token Plan, e nos produtos QwenWork, Qwen Studio e Qoder.
Ele é melhor que o Claude Opus 5.5?
Depende do teste. No DeepSWE v1.1, os números divulgados mostram o Qwen4-Max à frente, e no Terminal-Bench 4.0 o Claude Opus 5.5 está à frente. Os resultados são da Alibaba e de análises de terceiros.
Fonte: Alibaba Cloud
Análise Crítica
O Qwen4-Max entrega contexto de 1 milhão de tokens, visão nativa e uma redução de custo por tarefa de cerca de 60% frente ao Qwen3.8-Max, segundo a Alibaba. As ressalvas são objetivas: os números são autodeclarados, os veículos divergem sobre o percentual exato de redução de custo, o preço de tabela vem da imprensa e não do comunicado, o comparativo com o Claude Opus 5.5 é misto (à frente no DeepSWE, atrás no Terminal-Bench 4.0) e vem de análises de terceiros sobre os gráficos da empresa, os pesos do Max são fechados e a Alibaba não informa nada específico sobre o Brasil.
A visão do canal Invente com IA
Se você monta agentes ou fluxos de código, vale testar o Qwen4-Max no QwenCloud em tarefas reais e comparar qualidade, tempo e custo por tarefa com Claude, GPT e Gemini. Para rodar modelos localmente, espere os modelos menores da série Qwen4, que a Alibaba promete abrir.