
A MiniMax lançou oficialmente o M3.1 Flash, modelo da série Flash voltado a agentes, programação, uso de computador e cibersegurança, e confirmou que o misterioso Space Bunny, modelo que circulava de forma anônima entre desenvolvedores, era uma versão inicial dele. Segundo a empresa, o Space Bunny processou mais de 200 trilhões de tokens antes da revelação. O M3.1 Flash custa US$ 0,15 por milhão de tokens de entrada e US$ 0,60 por milhão de saída.
O que a MiniMax promete com o M3.1 Flash
A MiniMax descreve um salto de geração em tarefas de agentes, programação, uso de computador e cibersegurança, com inferência online quase três vezes mais rápida e custo de uso 70% menor que o do modelo anterior em tarefas de agentes. Em uso comum, a velocidade de saída chega a mais de 200 tokens por segundo, com mediana acima de 170 tokens por segundo.
- Preço da API: US$ 0,15 por milhão de tokens de entrada, US$ 0,60 de saída e US$ 0,015 de entrada em cache, em preço único.
- Onde usar: já está na API da MiniMax, no M Plan (assinatura) e no MiniMax Code.
- Pesos abertos: o post oficial diz que os pesos serão liberados depois, e a documentação da empresa descreve o M3.1 Flash como modelo de pesos abertos. Veículos que acompanham o lançamento citam 23 de outubro como data.
- Versão Pro: a MiniMax diz que o Pro, que amplia os limites de inteligência, também chega depois.
Na versão preview, a documentação da MiniMax já descrevia contexto de 1 milhão de tokens e profundidade de raciocínio ajustável.
Os números divulgados pela MiniMax
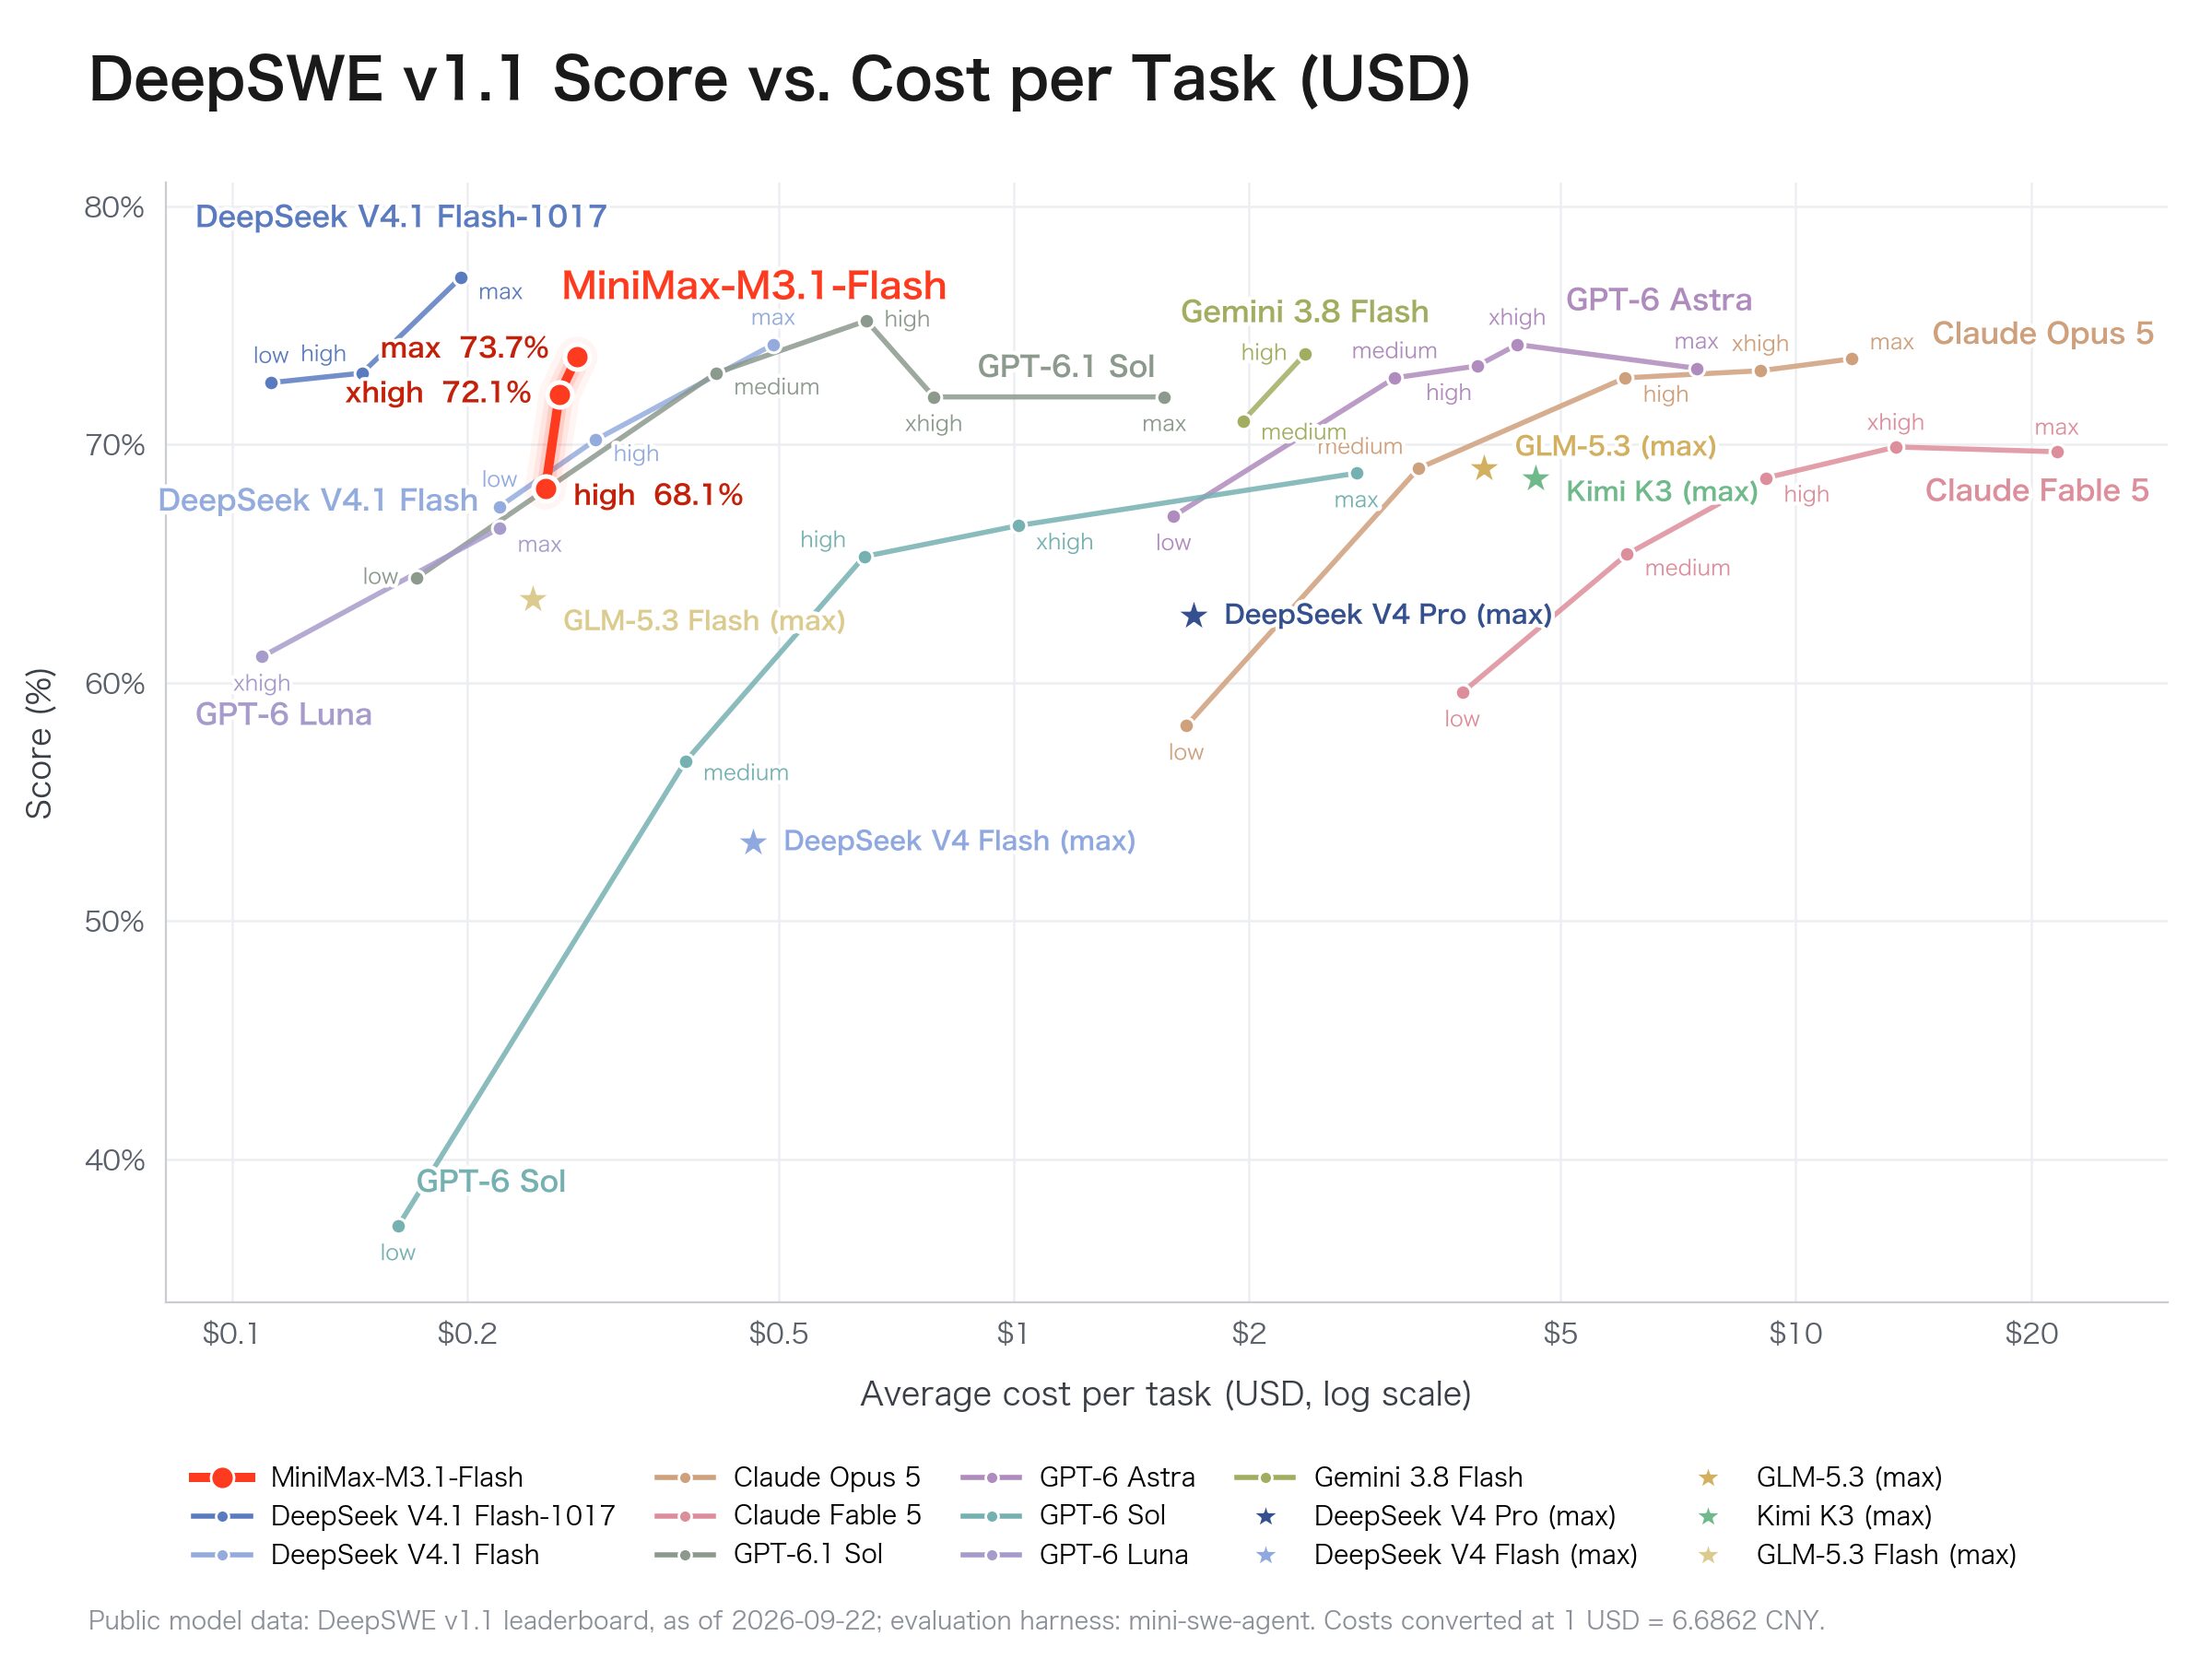
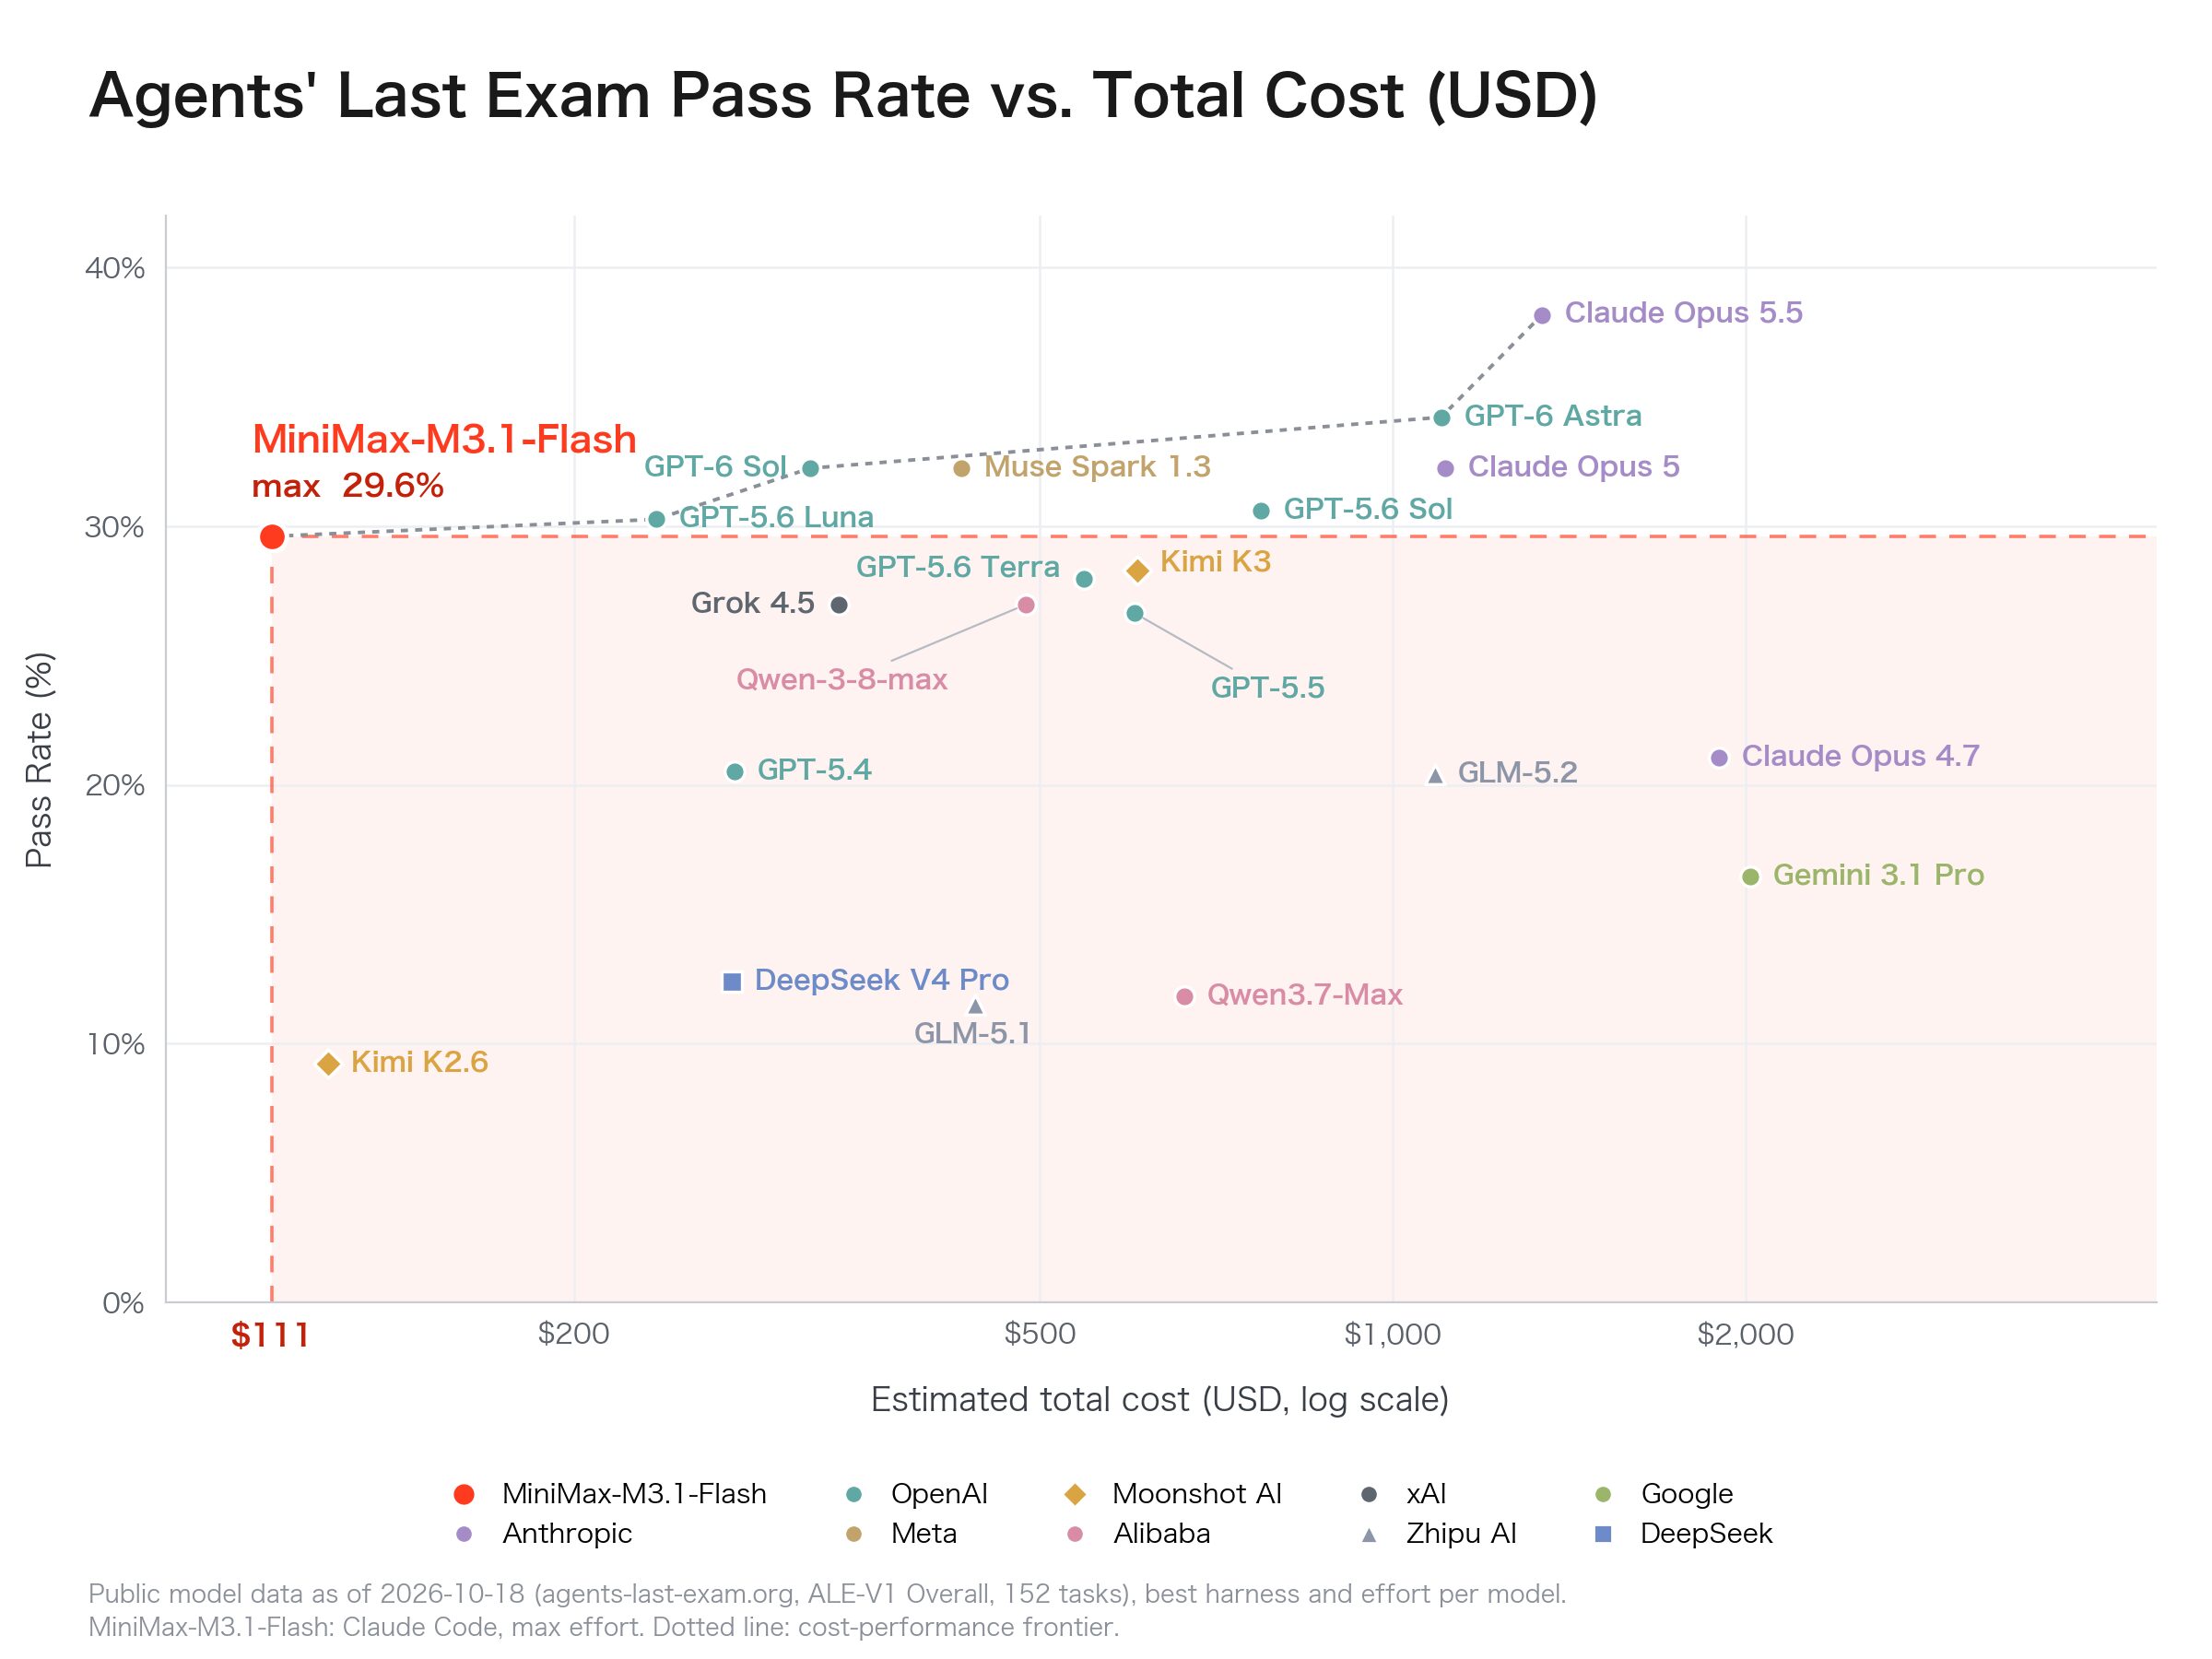
Os resultados abaixo vêm do post da própria MiniMax. Em programação, o M3.1 Flash marca 73,7% no DeepSWE v1.1, benchmark em que o modelo precisa entender código, desenvolver funções, corrigir problemas e validar o trabalho com testes. Em uso de computador, são 61,7 pontos no OSWorld V2 e 29,6 no Agents’ Last Exam (ALE), e a empresa afirma que ele é o primeiro entre os modelos chineses nos dois. No BankerToolBench, que testa planejamento em várias etapas e uso encadeado de ferramentas em finanças, marca 76,2. Em cibersegurança, são 82% no CyberGym.
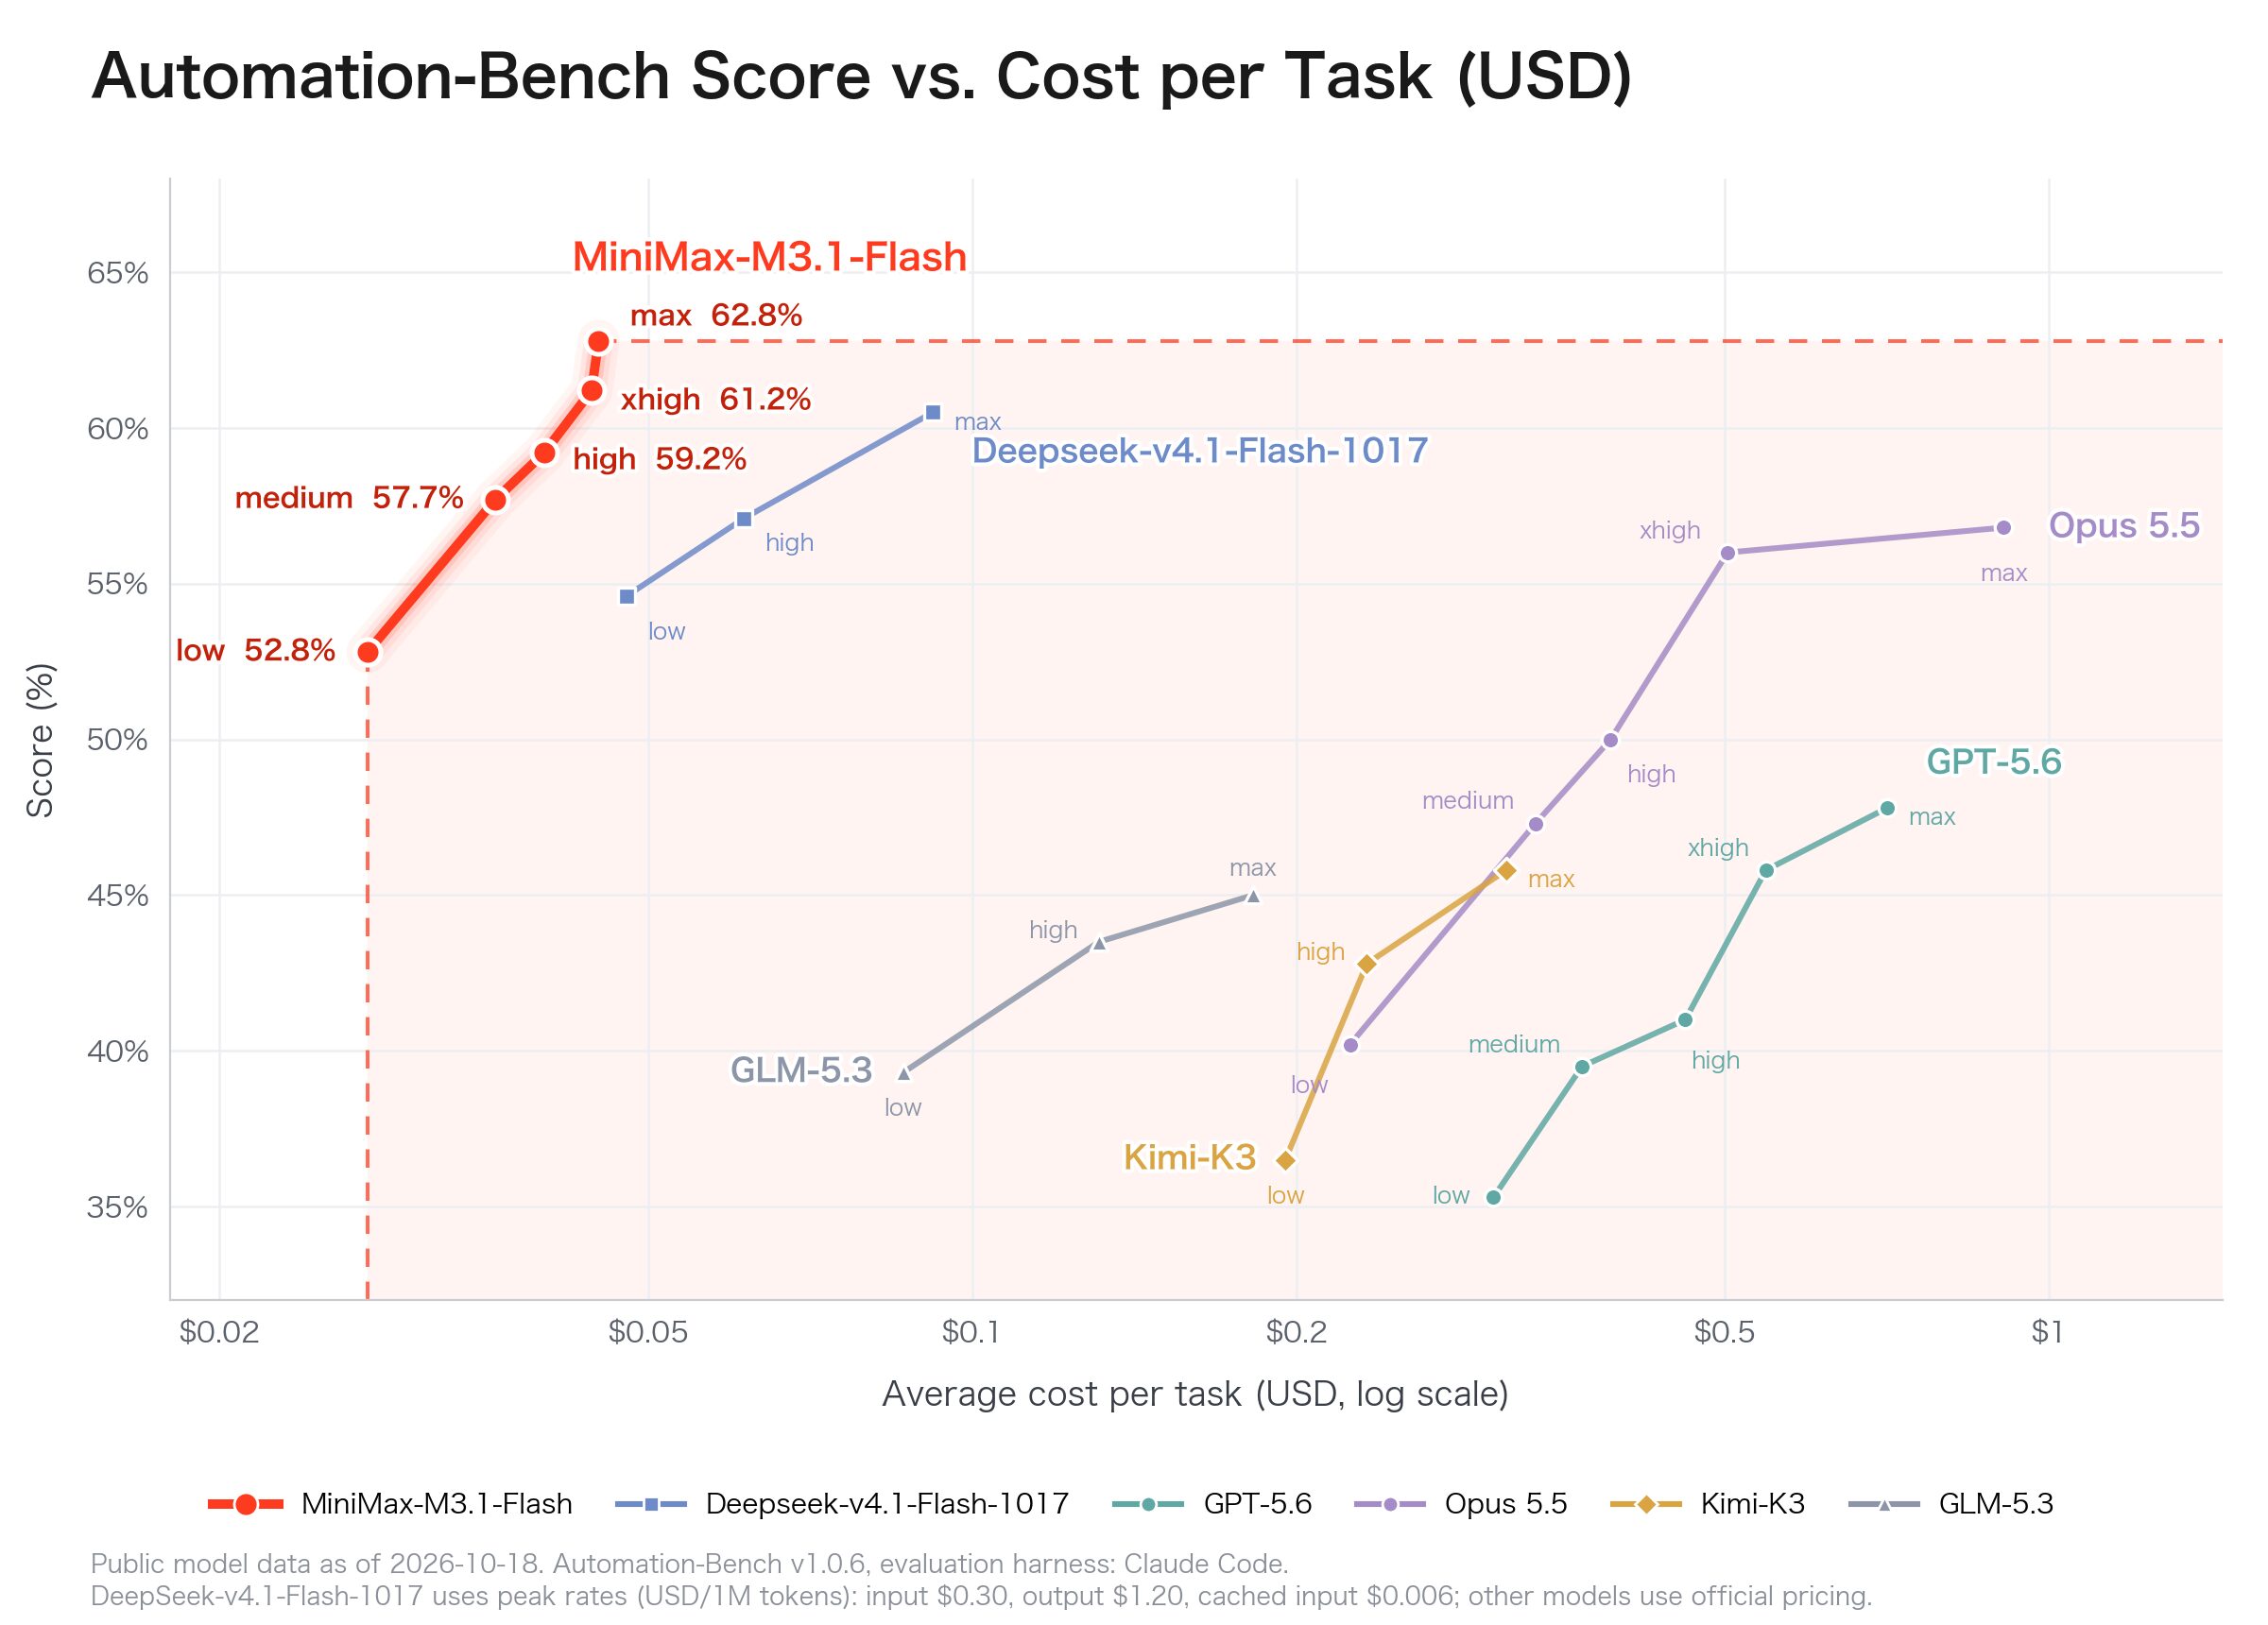
No AutomationBench-AA, que mede fluxos de trabalho reais de empresas em sistemas SaaS, o gráfico oficial mostra 62,8% no esforço máximo, com custo médio por tarefa em torno de US$ 0,04. No mesmo gráfico, o Opus 5.5 aparece em cerca de 57% a um custo bem maior, por volta de US$ 0,90 por tarefa.
O que os gráficos mostram e o que não mostram
A MiniMax destaca desempenho equivalente ao de modelos de ponta com custo muito baixo por tarefa, e os gráficos sustentam esse ponto, mas não mostram liderança em pontuação. No DeepSWE, o gráfico traz o DeepSeek V4.1 Flash-1017 acima do M3.1 Flash no esforço máximo, e o próprio post fala em desempenho ao lado dos melhores modelos. No ALE, o Opus 5.5 aparece em torno de 38% e o GPT-6 Astra em cerca de 34%, contra 29,6% do M3.1 Flash, que tem custo total estimado em US$ 111, muito abaixo dos demais.
Os gráficos informam as condições de teste: o AutomationBench usou o Claude Code como ambiente de avaliação, e os dados dos outros modelos são públicos até 18 de outubro, o DeepSWE usa dados do ranking público de 22 de setembro. Como são resultados divulgados pela própria empresa, vale validar com as suas tarefas. Alguns veículos publicaram números diferentes para o AutomationBench e o ALE, então usei apenas os do post oficial.
Para quem é e disponibilidade
É para desenvolvedores e equipes que querem rodar muitos agentes e tarefas de programação com custo baixo, e para quem precisa de velocidade de resposta. Para quem exige a máxima precisão em tarefas profissionais complexas, os gráficos indicam modelos como o Opus 5.5 e o GPT-6 Astra à frente em pontuação. Quem quer rodar o modelo localmente precisa esperar a liberação dos pesos. A MiniMax não detalhou disponibilidade por país.
Perguntas frequentes
O que era o Space Bunny?
Era um modelo anônimo que circulava entre desenvolvedores. A MiniMax confirmou que se tratava de uma versão inicial do M3.1 Flash e diz que ele processou mais de 200 trilhões de tokens.
Quanto custa o MiniMax M3.1 Flash?
US$ 0,15 por milhão de tokens de entrada, US$ 0,60 por milhão de saída e US$ 0,015 por milhão de entrada em cache.
O M3.1 Flash terá pesos abertos?
Segundo a MiniMax, os pesos serão liberados depois do lançamento, e veículos citam 23 de outubro. A empresa também diz que uma versão Pro chega mais tarde.
Fonte: MiniMax
Análise Crítica
O M3.1 Flash chama atenção pela relação entre custo e desempenho: nos gráficos da própria MiniMax ele fica entre os mais baratos por tarefa e perto dos melhores em programação e automação. O ponto de cautela é que o post destaca custo e velocidade, mas os gráficos não mostram liderança em pontuação, já que no DeepSWE há um modelo da DeepSeek acima e no ALE o Opus 5.5 e o GPT-6 Astra ficam bem à frente. Os números são divulgados pela empresa, com ambientes de teste indicados, e a data dos pesos abertos ainda depende de confirmação. Para volume alto de tarefas de agentes e programação, vale o teste com os próprios dados. Para casos que exigem a maior precisão possível, a comparação direta com os modelos líderes é recomendada.
A visão do canal Invente com IA
Se você roda muitos agentes ou tarefas de programação e o custo pesa, vale testar o M3.1 Flash pela API: pegue um fluxo seu, rode no modelo atual e no M3.1 Flash e compare taxa de acerto, tempo e custo por tarefa. Se a ideia é rodar localmente ou em infraestrutura própria, aguarde a liberação dos pesos e confira a licença quando sair.