
A Meta lançou o Muse Wonder e o Muse Wonder Full, os modelos mais capazes da empresa até agora, feitos para agentes de IA que executam tarefas pessoais e profissionais em nome do usuário. O Muse Wonder já está disponível pela Meta Model API e pelo Muse Code, e a versão Full está liberada para assinantes do Muse Code.
Memória que atravessa conversas e foco que não desiste no primeiro obstáculo
Agente de IA é um programa que não só responde perguntas, mas age: abre o navegador, usa aplicativos e conclui tarefas. A aposta da Meta para esse tipo de uso está em dois recursos que ela batizou de Active Memory e Active Focus.
O Active Memory, ou memória ativa, guarda informações importantes sobre você entre uma conversa e outra e recupera o que serve para a tarefa do momento. Na prática, é o assistente que já sabe que você corre aos sábados e não precisa ouvir isso de novo toda semana.
O Active Focus, ou foco ativo, descreve como o modelo continua trabalhando numa meta difícil. Ele tenta caminhos alternativos, contorna bloqueios e se adapta a informações novas. Quando algo não está claro, pede esclarecimento, e antes de uma ação importante confirma com você.
O Muse Wonder evolui do Muse Spark, com melhorias no pré-treino e no aprendizado por reforço. Pré-treino é a fase em que o modelo aprende com uma enorme quantidade de texto. O aprendizado por reforço funciona como um treinador que premia as respostas certas e refina o comportamento depois. O treinamento foi feito no Prometheus, data center da Meta em escala de gigawatt.
Segundo a Meta, o modelo também aplica conhecimento especializado em direito, finanças e saúde, como entender um contrato de aluguel ou interpretar informações financeiras e de saúde.
Os números oficiais: onde o Muse Wonder lidera
A tabela abaixo é a comparação completa publicada pela Meta, com o Muse Wonder Full e o Muse Wonder frente ao Claude Fable 5.1, ao GPT-6 Astra e ao Claude Opus 5.5, todos no nível máximo de esforço.
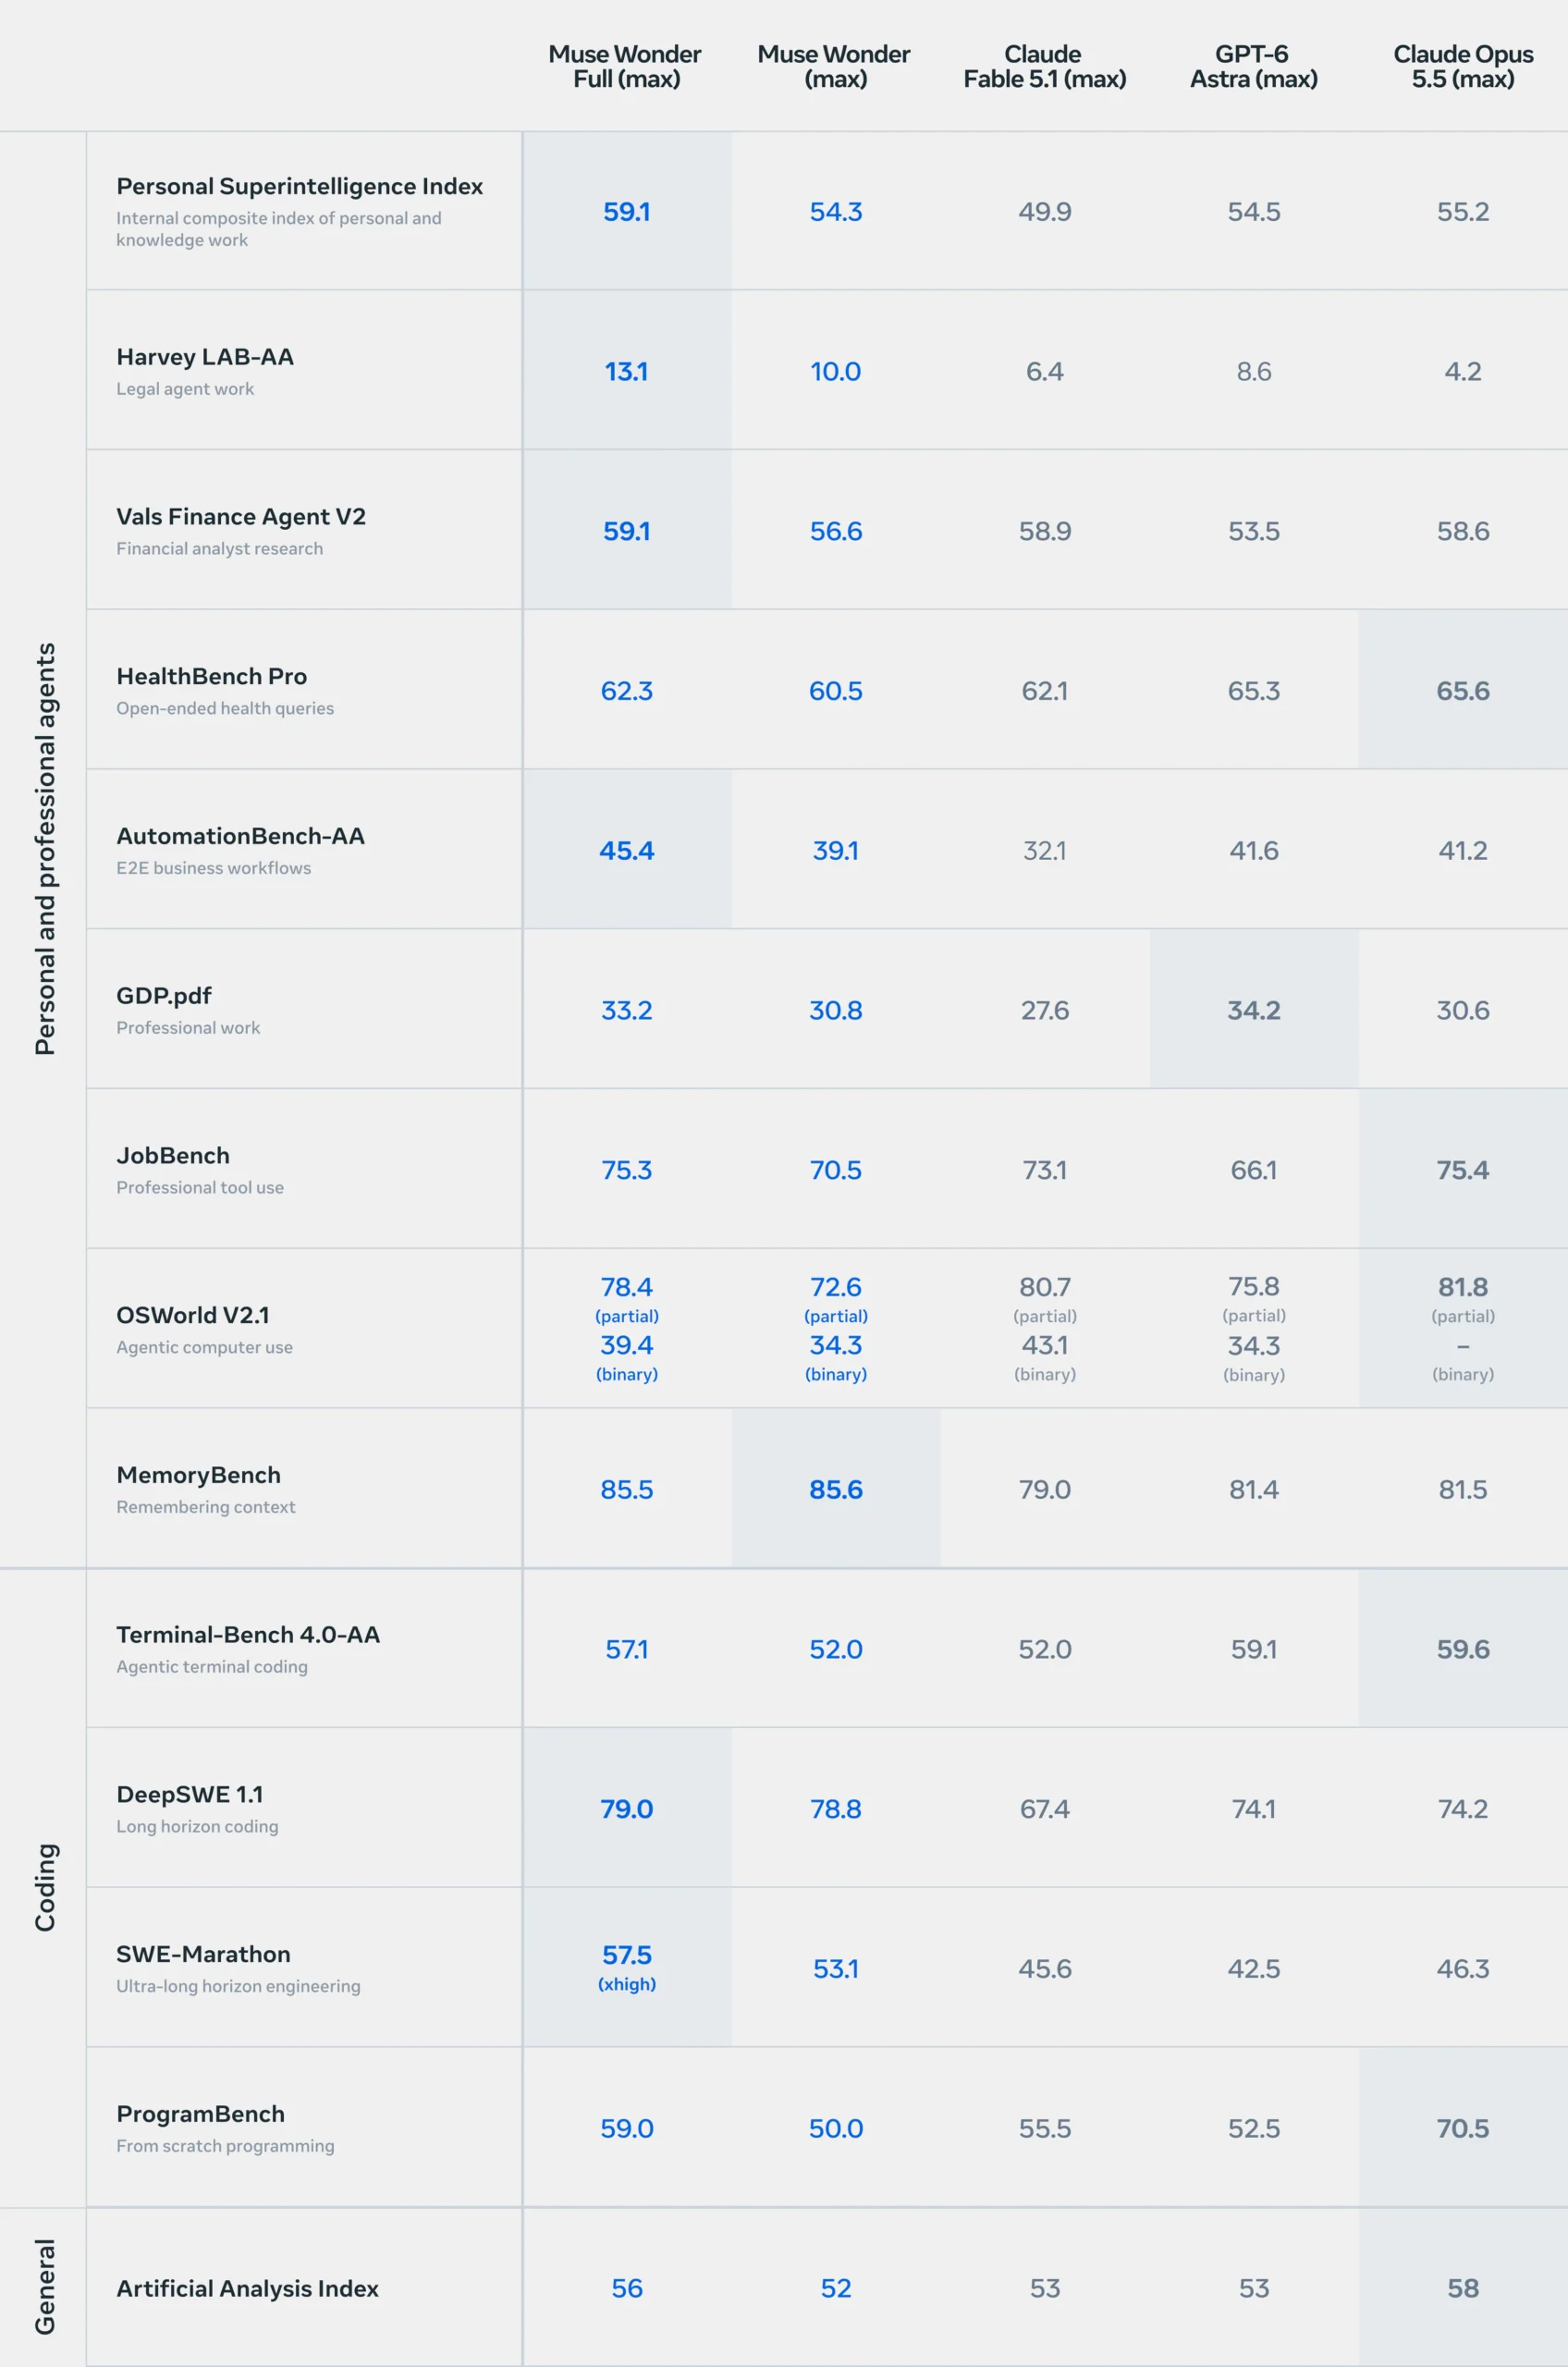
- O Muse Wonder Full lidera em sete avaliações: Personal Superintelligence Index (59,1), Harvey LAB-AA (13,1), Vals Finance Agent V2 (59,1), AutomationBench-AA (45,4), DeepSWE 1.1 (79,0), SWE-Marathon (57,5) e MemoryBench (o Muse Wonder padrão marca 85,6 e o Full 85,5).
- No SWE-Marathon, que mede trabalho em projetos de software muito longos, o Full marcou 57,5 contra 46,3 do Opus 5.5, 45,6 do Fable 5.1 e 42,5 do GPT-6 Astra.
- O Opus 5.5 aparece na frente no HealthBench Pro (65,6), no Terminal-Bench 4.0-AA (59,6), no OSWorld V2.1 parcial (81,8), no ProgramBench (70,5 contra 59,0) e no Artificial Analysis Index (58 contra 56).
- No GDP.pdf, o melhor resultado é do GPT-6 Astra (34,2). No JobBench, o Opus 5.5 (75,4) fica a 0,1 ponto do Muse Wonder Full (75,3).
O Personal Superintelligence Index é um índice composto interno da Meta para trabalho pessoal e de conhecimento, então vale ler esse número como referência da própria empresa. Os demais testes são avaliações conhecidas do mercado.
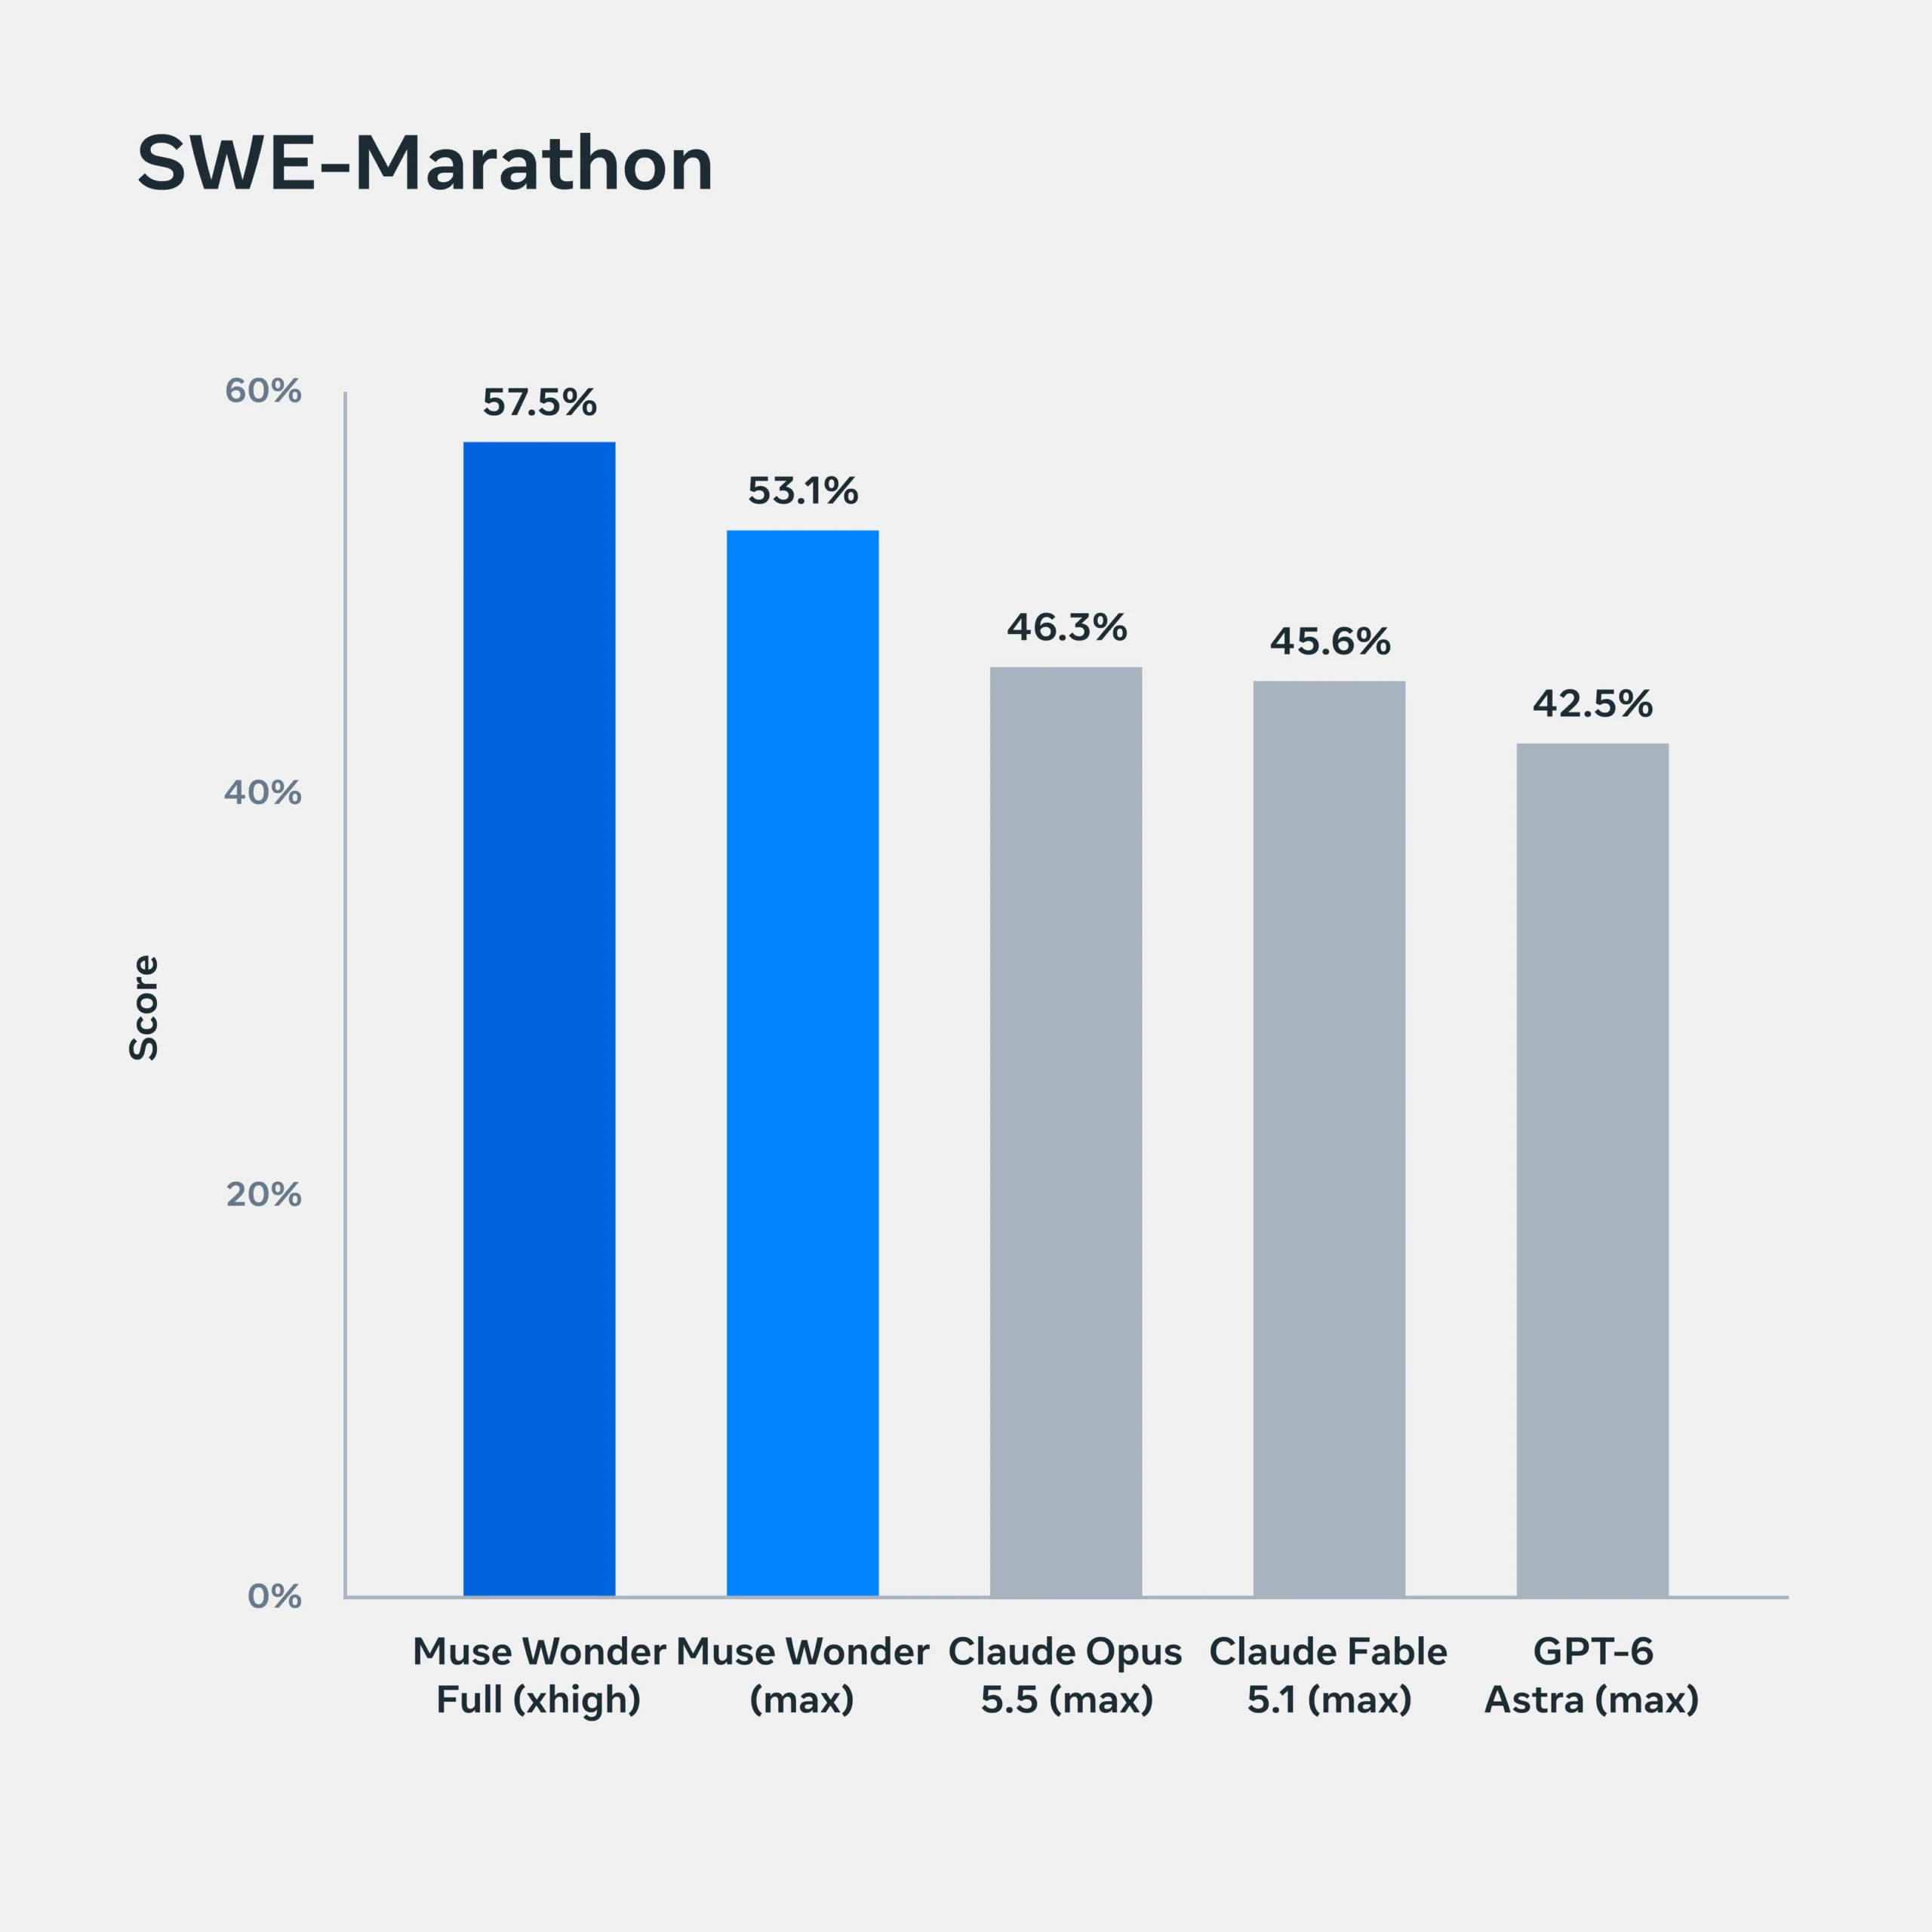
Para o Active Focus, a Meta usa o FocusBench e o SWE-Marathon. Para a memória, o MemoryBench, onde os dois modelos ficam em 85,5 e 85,6, contra 81,5 do Opus 5.5, 81,4 do GPT-6 Astra e 79,0 do Fable 5.1.
Generalização: desempenho em tarefas que o modelo não treinou
A Meta também mostra como o modelo se sai em tarefas fora do que foi priorizado no pós-treino. No gráfico, cada ponto é um nível de esforço de raciocínio. O eixo horizontal mostra o desempenho nas tarefas treinadas e o vertical, nas tarefas não treinadas.
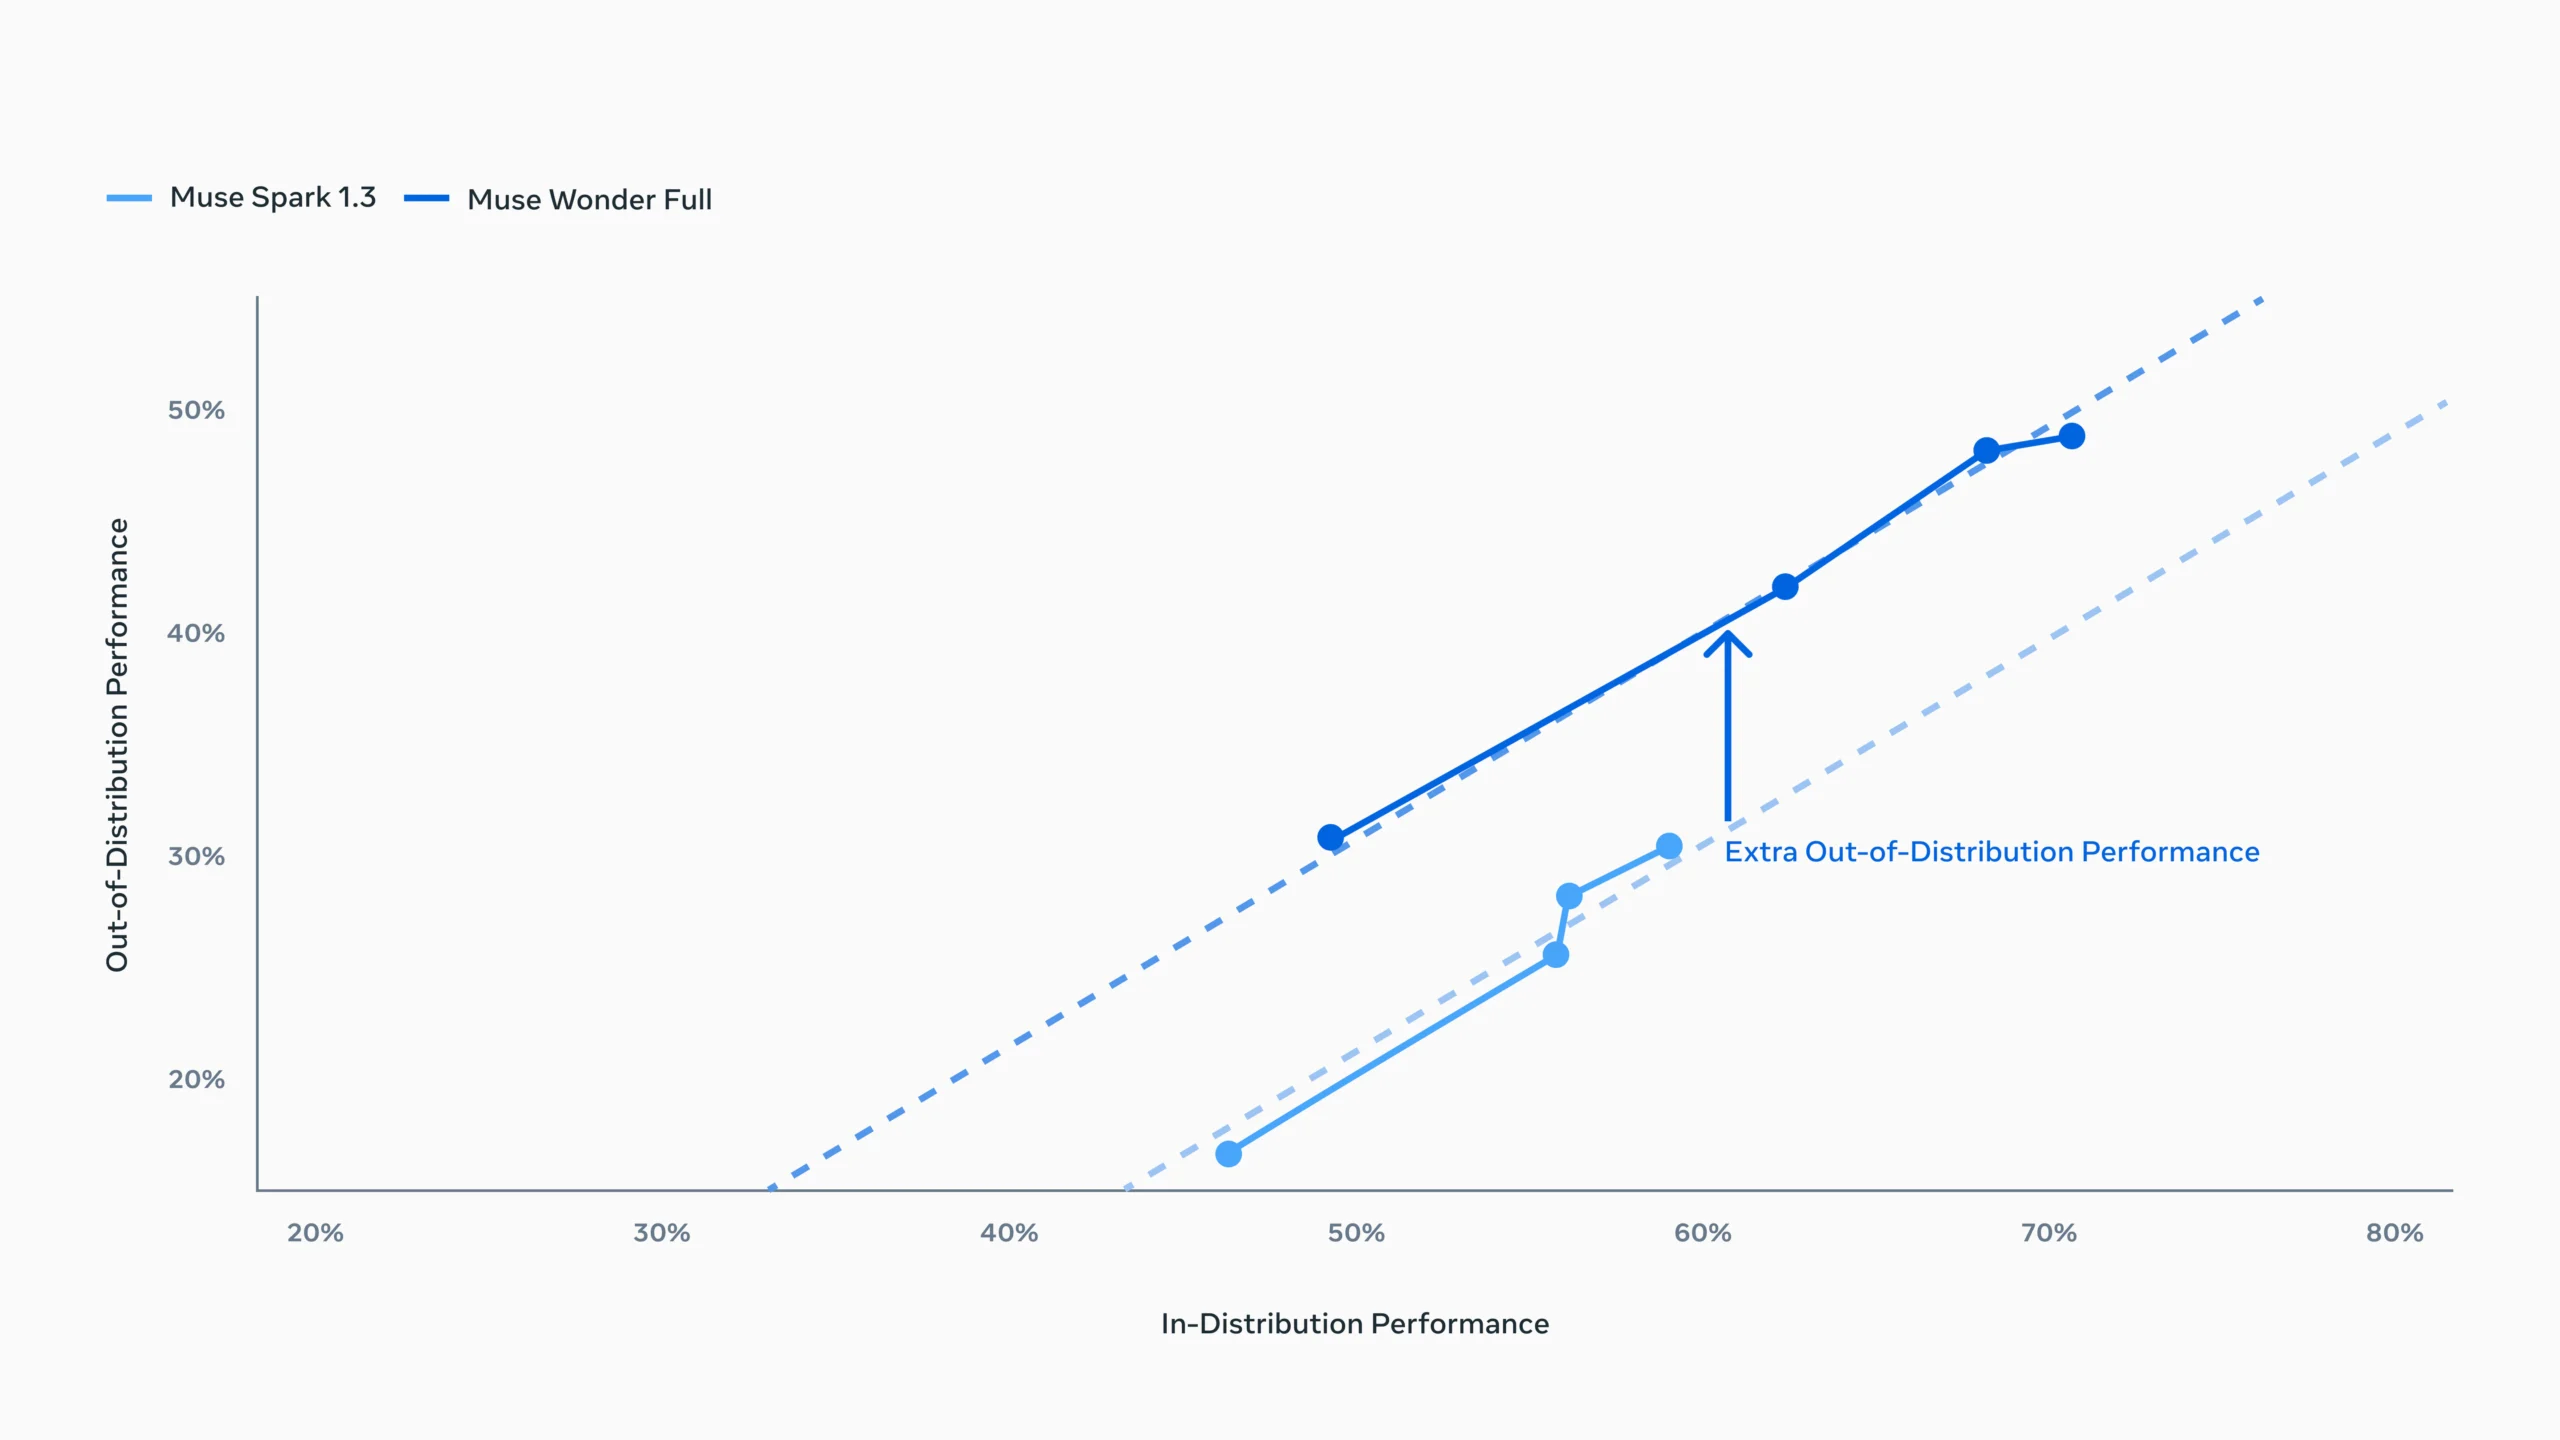
Os dois modelos melhoram de forma parecida ao receber mais computação na hora de responder, mas o Muse Wonder Full fica acima da tendência do Muse Spark 1.3. Pelo gráfico, ele vai de cerca de 31% a cerca de 49% fora da distribuição, contra cerca de 17% a 30% do Spark. A Meta atribui isso ao modelo-base maior, e o efeito importa para agentes pessoais, que lidam com muitas combinações de metas, ferramentas e restrições.
As demonstrações em vídeo
O post traz demonstrações em gravação de tela. Os vídeos ficam hospedados na página oficial da Meta e podem ser assistidos em research.meta.ai/blog/muse-wonder. Abaixo, quadros de algumas delas.
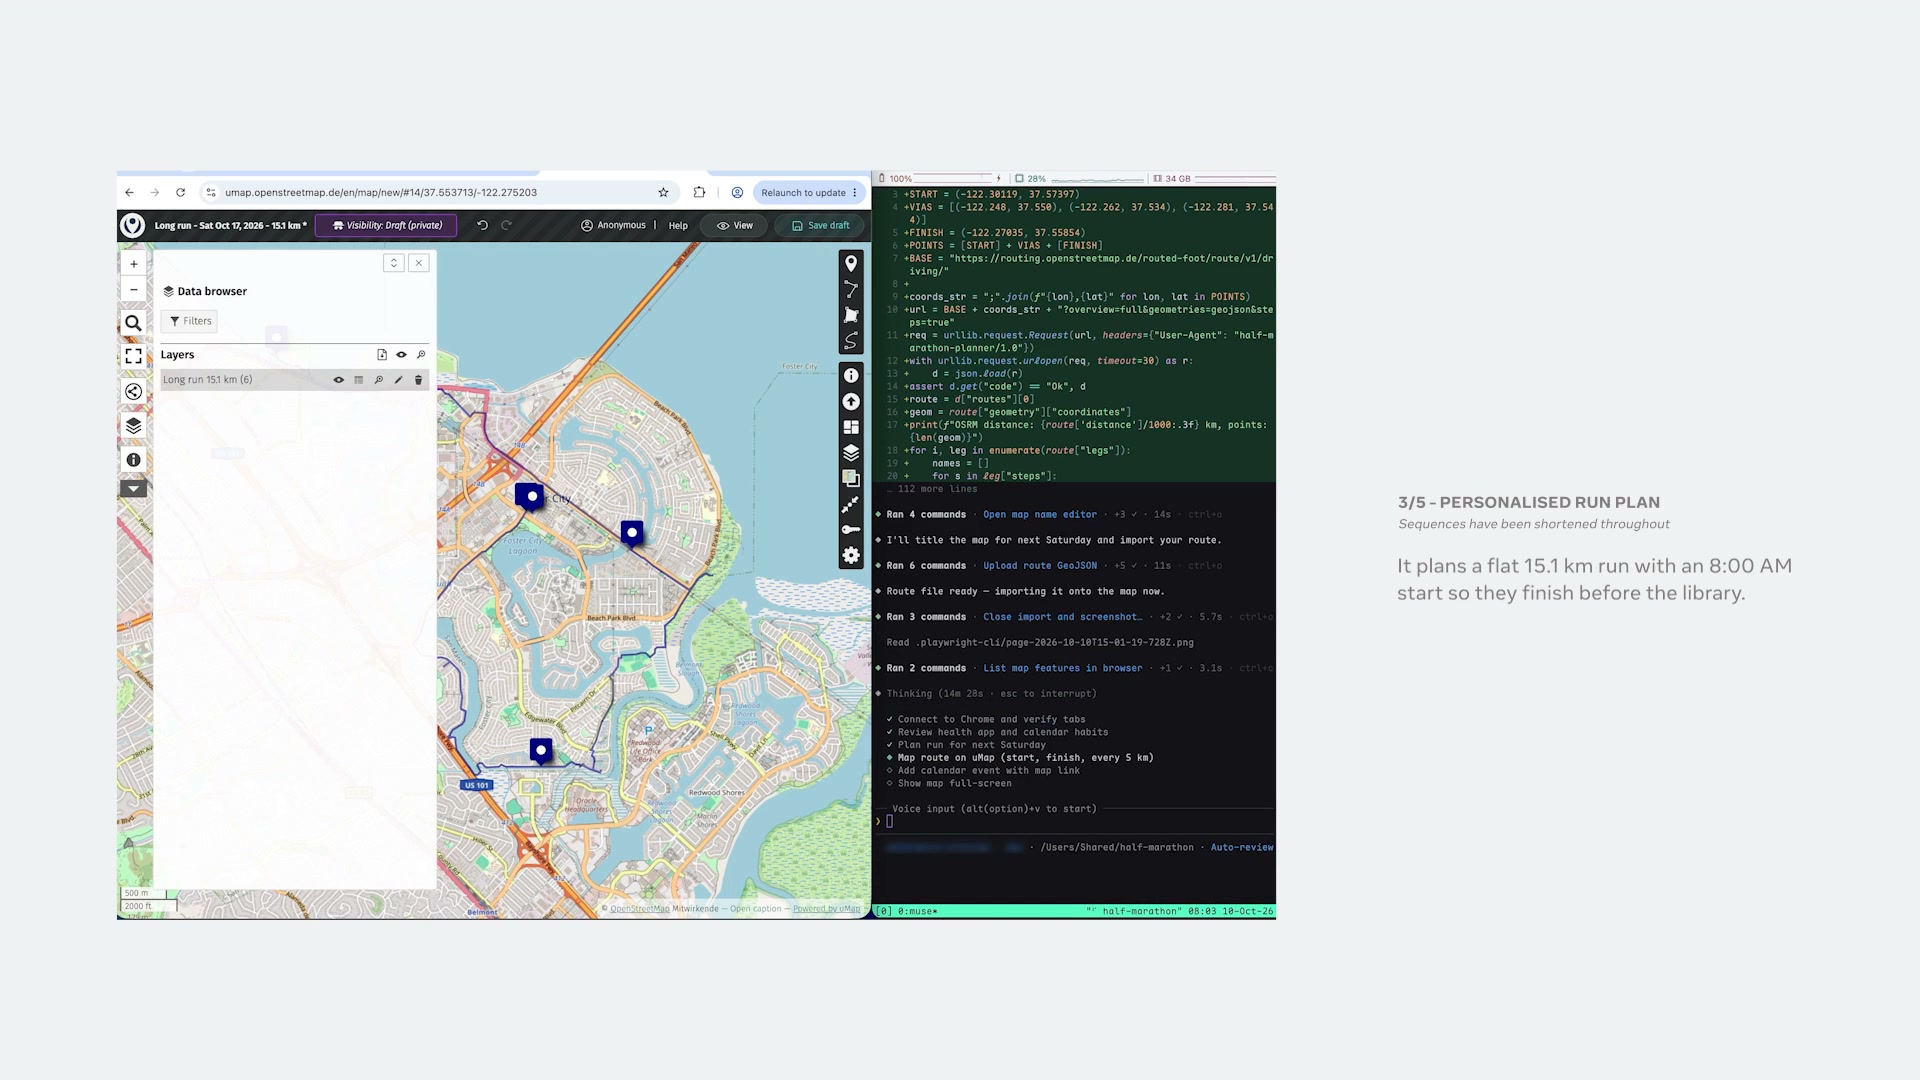
No planejamento de corrida de sábado, o modelo trabalha no navegador e em vários aplicativos e monta um plano de 15,1 km com largada às 8h, para a pessoa terminar antes de ir à biblioteca.
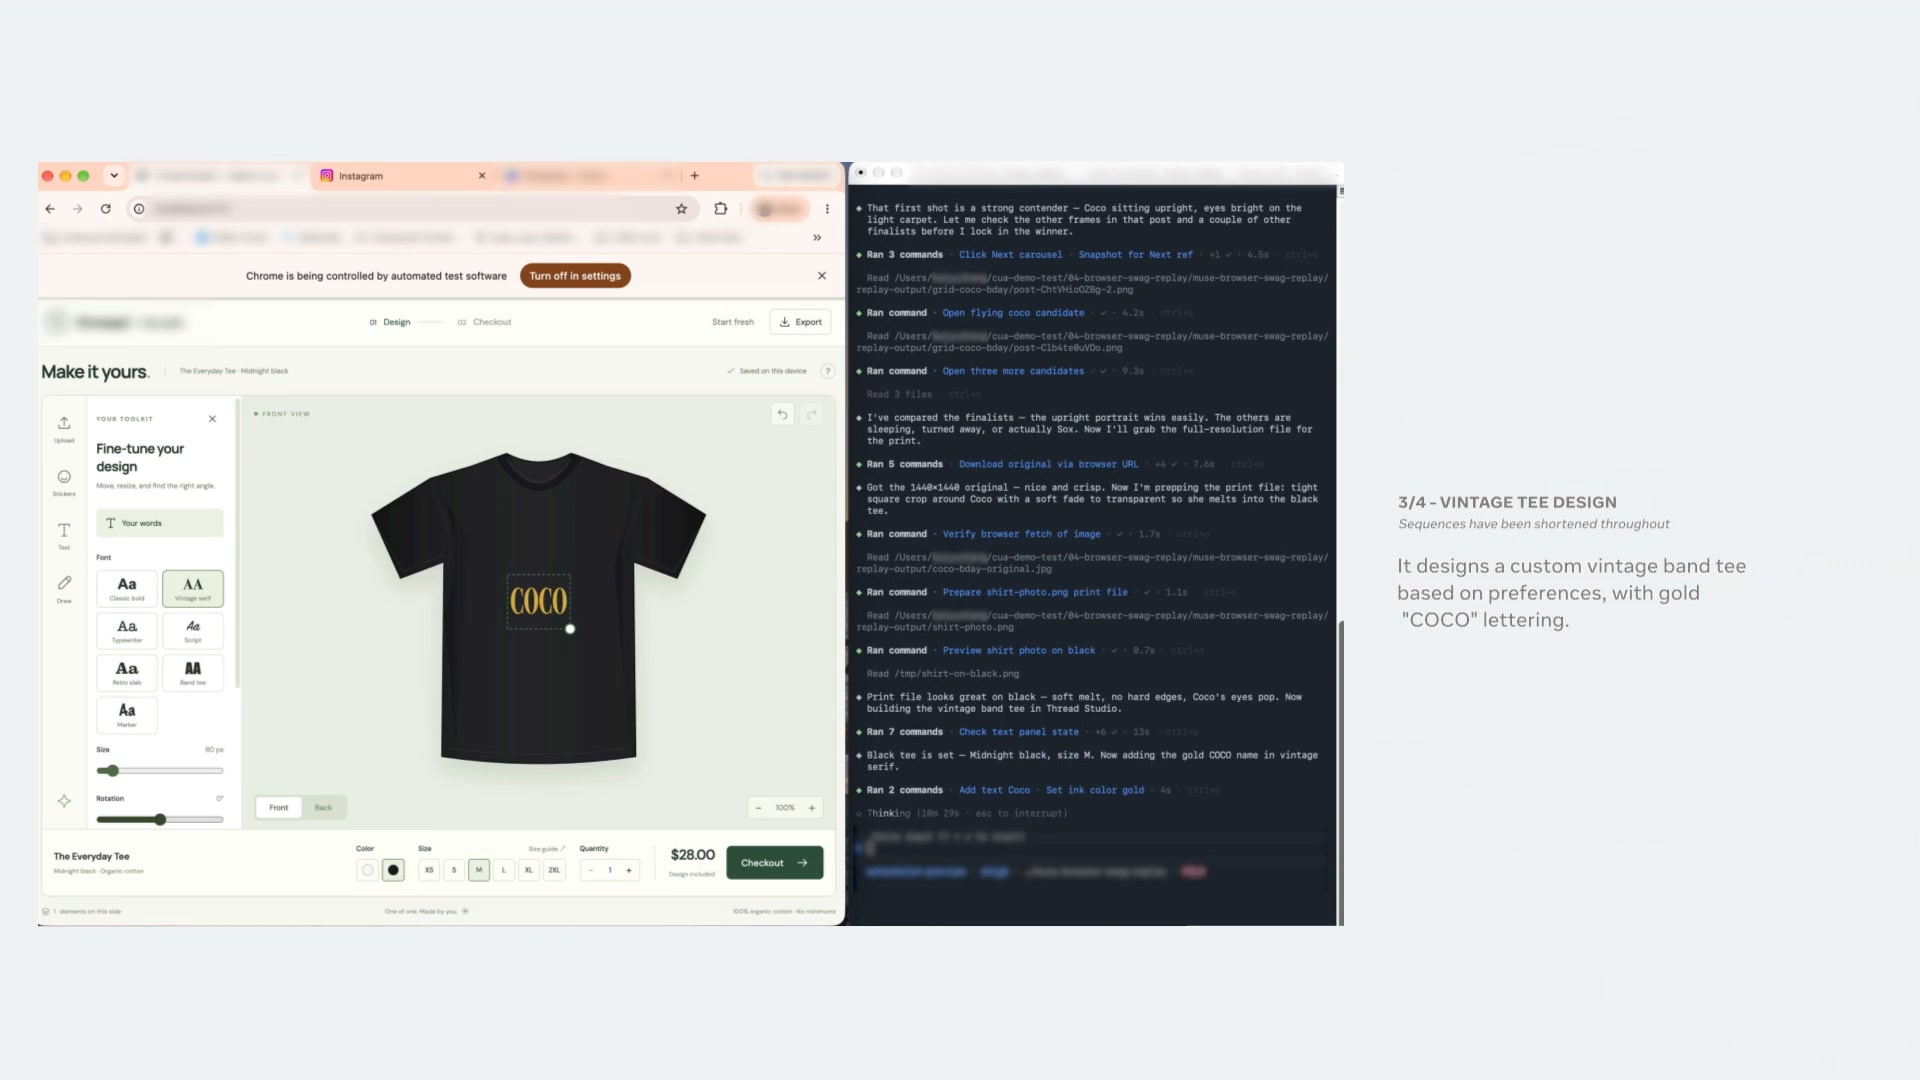
Na demonstração de presentes personalizados, o modelo projeta e encomenda uma camiseta vintage com o nome "COCO" em dourado, a partir de fotos reais de um perfil pessoal do Instagram.
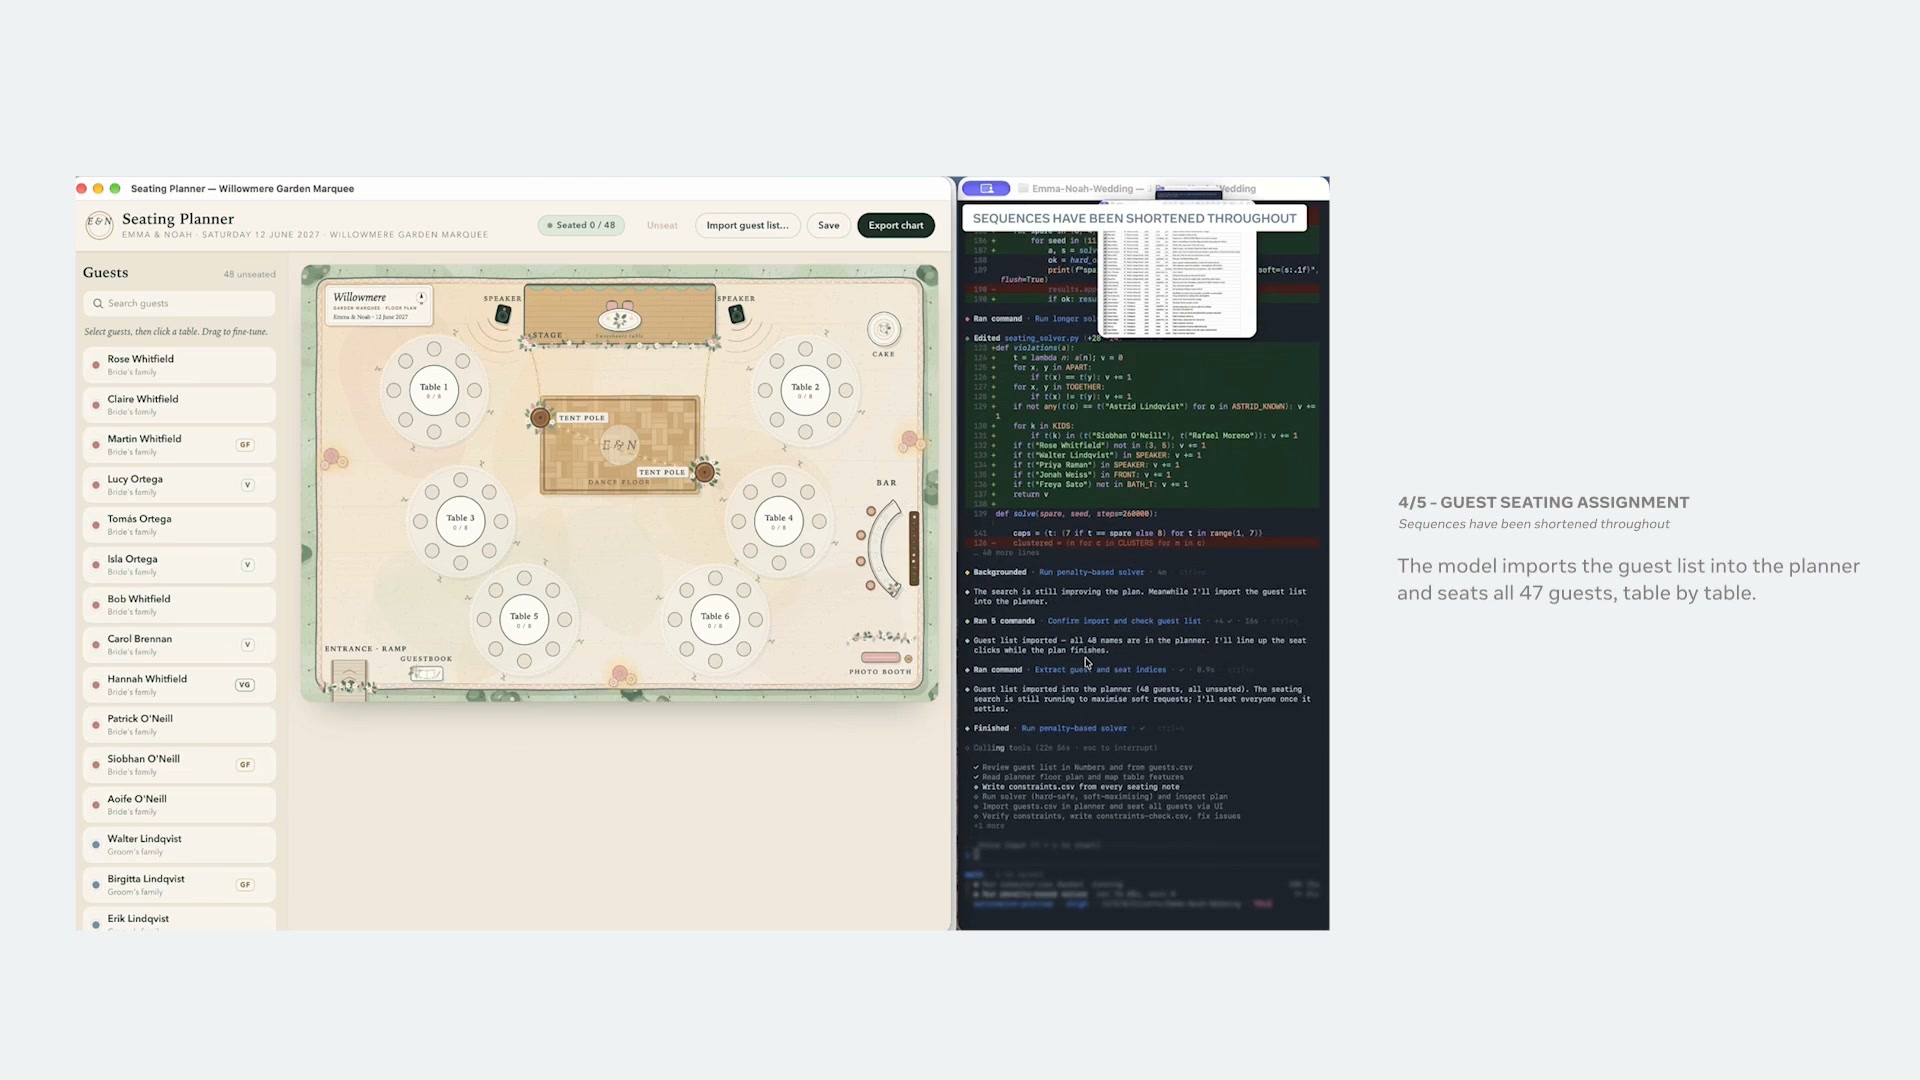
Na terceira, o modelo importa a lista de 48 convidados e monta o mapa de mesas de um casamento a partir de uma lista de requisitos complexos. O post traz ainda demos de um jogo de cozinha 3D jogável criado a partir de imagens, apoio de bem-estar e análise de um sinistro de seguro.
Segurança e disponibilidade
Como um agente pessoal pode lidar com mensagens, agendas e documentos privados, a Meta diz ter treinado o modelo para exercer discrição com informações privadas e resistir a instruções maliciosas. A empresa afirma que o Muse Wonder tem suas salvaguardas mais fortes até hoje contra uso indevido em áreas química, biológica, radiológica, nuclear e cibernética, preservando capacidades cibernéticas para uso defensivo, conforme o Meta Superintelligence Scaling Framework. Um relatório completo com avaliações de segurança está previsto para breve.
O Muse Wonder vai chegar também ao app Muse, começando pelos assinantes, e deve alimentar a geração de artefatos e processos que exigem mais inteligência. A Meta não informou disponibilidade específica para o Brasil.
Perguntas frequentes
O que é o Muse Wonder da Meta?
É a nova família de modelos de IA da Meta, formada pelo Muse Wonder e pelo Muse Wonder Full, criada para agentes que executam tarefas pessoais e profissionais. Combina memória entre conversas (Active Memory) com persistência para concluir objetivos difíceis (Active Focus).
Quem pode usar o Muse Wonder hoje?
O Muse Wonder está disponível pela Meta Model API e pelo Muse Code. O Muse Wonder Full está disponível para assinantes do Muse Code. O app Muse recebe o modelo em breve, primeiro para assinantes.
Já dá para usar o Muse Wonder no Brasil?
A Meta não informou disponibilidade específica para o Brasil. Quem desenvolve pode testar pela API, conforme as regras de acesso da Meta Model API.
Fonte: Meta AI Research
Análise Crítica
O Muse Wonder coloca a Meta na conversa de agentes com resultados fortes em memória, trabalho jurídico, finanças e projetos longos de código. O SWE-Marathon, com 57,5 contra 46,3 do Opus 5.5, e o Harvey LAB-AA, com 13,1 contra 8,6 do GPT-6 Astra, são as diferenças mais claras da tabela. Em compensação, o Opus 5.5 segue à frente em ProgramBench, Terminal-Bench, OSWorld, HealthBench Pro e no Artificial Analysis Index, ou seja, a vantagem do Muse Wonder está nos agentes de longa duração e na memória, não em tudo. Dois cuidados ajudam a ler os números: o Personal Superintelligence Index é um índice interno da Meta, e os resultados são divulgados pela própria empresa, então vale confirmar em testes próprios. Ele é indicado para quem desenvolve agentes e automações e para quem usa o Muse Code, e ainda não é para quem espera um app pronto, já que a chegada ao Muse vem depois.
A visão do canal Invente com IA
Se você desenvolve agentes ou automações, vale testar o Muse Wonder pela Meta Model API. O ponto forte dele é tarefa longa, que exige insistir até o fim, então escolha um fluxo que hoje trava no meio, como uma refatoração grande ou uma automação com várias etapas. Rode o mesmo fluxo no modelo que você já usa e compare quantas vezes cada um precisa de ajuda sua. Se o Muse Wonder sustentar mais tempo sozinho, é tempo seu economizado toda semana.